
CFD / AIサロゲート / OMNIVERSE KIT-CAE
CFDから対話型データセンターツインへ
サロゲートモデルは、GPU負荷設定と4台の空調機のON/OFF状態を入力として、3,494,065個の流体セルにおける温度と3成分の速度を予測します。Kit-CAEは、インメモリのパイプラインを通じて予測された場を可視化します。
本記事では、100ケースで構築したサロゲートモデルと、追加の5つの補間ケースに対する外部精度評価の結果を報告します。コンター図とレイテンシのベンチマークには、発熱率92%、空調機1・3・4がONのケースを使用しています。すべての処理時間について、コールド実行かウォーム実行かを明記しています。
100
Fluentケース
発熱条件10段階 × 空調構成10パターン
約349万
流体セル
セル順序を整合させた共通メッシュ
5
外部テストケース
追加4ケース+発熱率92%のケース
1.552秒
ウォーム更新
温度+速度
結果の読み方
外部精度評価は、発熱率15%、38%、62%、85%、92%の5条件と、5つの空調構成を対象としています。これらの発熱率は、10%刻みの学習条件の間に位置しており、空調構成はすべて学習データに含まれています。このテストは補間を評価するものであり、学習範囲外の設定や未学習の空調構成は対象としていません。コンター図には、発熱率92%、空調機1・3・4がON、2がOFFのケースのみを示します。
ワークフローの概要
ワークフローは、オフラインの学習段階と、オンラインの予測・可視化段階で構成されます。 サロゲートモデル は、GPU負荷設定と4台の空調機のON/OFF状態をCFDの場に対応付けます。可視化パイプラインは、更新のたびにFluentを再実行することなく、ボリューム、平面スライス、流線、流れのアニメーションを用いて予測された場を表示します。
主成分分析(PCA)は、各空間場を9つの成分で表現します。多層パーセプトロン(MLP)は、5つの運転条件入力からその係数を予測します。本実装は、選択した運転条件についてCFDの場を予測し、可視化します。リアルタイムのセンサー連携や冷却制御は実証していません。
01 · オフラインで学習
100件のFluentケース
セル順序を整合させ、PCAを適合し、4つのMLPアンサンブルを学習します。
02 · オンラインで予測
5つの入力 → 4つの場
GPU上で各場の9つの係数を予測します。
03 · KIT-CAEで確認
キャッシュ済みボクセル → 3D表示
ボリューム、スライス、流線、流れのアニメーションを確認します。
01 / CFDデータとセル順序の整合
モデルに与えるのは 5つの運転条件入力です。内訳は、GPU負荷設定1つと、4台の空調機のON/OFF状態です。
- GPU負荷設定: CFDモデルで指定する発熱率です。推論時には0〜1に正規化します。これはシナリオの設定値であり、リアルタイムに測定したGPU使用率ではありません。
- 4台の空調機: 各空調機に独立したON/OFF入力を1つずつ与えます。
データセットは、10段階の発熱率(10%〜100%、10%刻み)と10種類の冷却構成を組み合わせています。冷却構成の内訳は、2台をONにする6通りと、3台をONにする4通りです。これにより、収束済みの定常解析100ケースが得られます。例えば、空調機1・3・4をON、2をOFFとする構成があります。
各ケースから、セル中心の温度(Fluentの SV_T)と速度成分(SV_U, SV_V, SV_W)を取得します。速さは予測後に sqrt(u² + v² + w²)として算出し、5つ目の独立した場として学習することはありません。元のケースは、Fluent 2026 R1による倍精度の3次元解析結果です。境界条件、乱流設定、収束判定基準にはFluentのケースファイルの設定をそのまま使用し、本ワークフローでは再定義していません。
CFDモデル / データセンターの形状
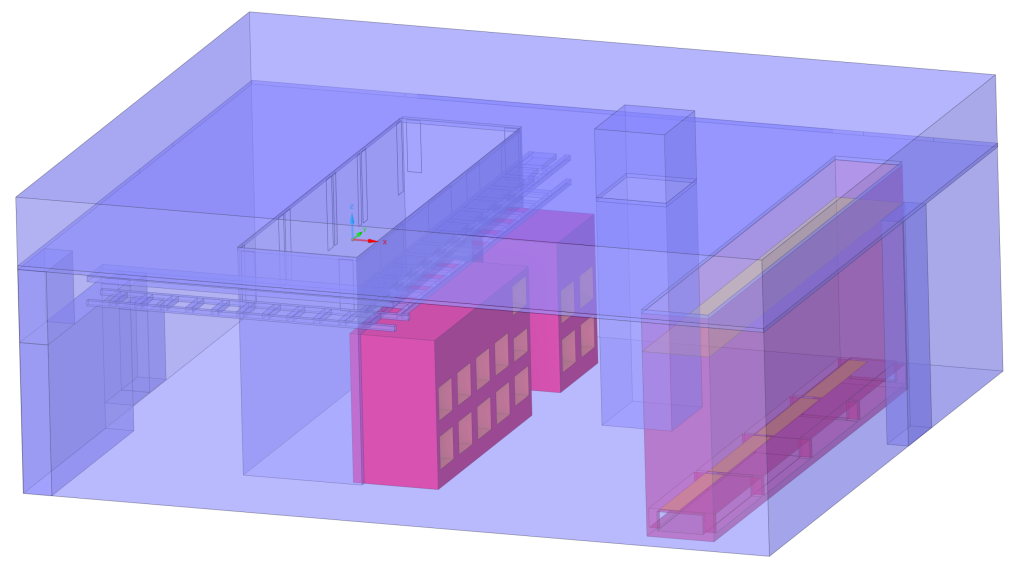
Fluentは起動時にセルを再分割する場合があるため、API出力の配列インデックス i が、元のHDF5データの同じインデックス i のセルと一致するとは限りません。データセット作成処理はFluentを一度起動し、流体セルの重心と4つの場をすべて読み込みます。64ビットのT/U/V/W値からセルごとのフィンガープリントを作成し、Fluent APIの順序からHDF5の順序へ対応付ける並べ替えを求めます。4つの量をセルごとに照合した後、残り99件の結果を h5pyで直接読み込みます。こうして、すべてのケースでセル順序が共通のデータセットを構築します。
空調構成ごとに層化して、ケースを学習用69件、検証用16件、内部テスト用15件に分割しました。入出力の標準化とPCAの適合には 学習ケースのみを使用します。検証データはモデル選択と学習停止の判定に使用し、内部テストデータは最終評価まで保持します。発熱率15%、38%、62%、85%、92%の外部5ケースは、この100ケースのデータセットとは別です。
02 / サロゲートモデル:PCAとMLPアンサンブル
各物理量のデータ行列では、行が運転条件のケース、列が3,494,065個の流体セルに対応します。標本空間のグラム行列 G = XcenteredXcenteredT/(n−1) を、セル間の共分散行列の代わりにGPU上で計算します。学習ケースが69件の場合、グラム行列のサイズは69 × 69です。グラム行列とPCAの適合にはfloat64を使用し、保存するPCA基底は推論用にfloat32へ変換します。
| 場 | PCA係数数 | 保存された累積寄与率 |
|---|---|---|
| 温度 | 9 | 0.999860 |
| 速度U | 9 | 0.999691 |
| 速度V | 9 | 0.999667 |
| 速度W | 9 | 0.999528 |
4つの独立したMLPアンサンブルが、それぞれの場について標準化された9つのPCA係数を予測します。各ネットワークは5入力、ニューロン数64・Tanh活性化の隠れ層2層、9出力で構成されます。学習にはAdamを用い、学習率は5×10⁻⁴、重み減衰は10−4、バッチサイズは8、最大エポック数は3,000、早期終了判定までの待機期間は300エポックとします。損失関数は、標準化された係数空間での平均二乗誤差です。
モデル選択では、固定して抽出した50,000個の検証セルを再構成し、 MAE + 0.25 × 絶対誤差のP99を最小化します。このスコアには、平均絶対誤差と絶対誤差の99パーセンタイルの両方が含まれます。各場について、異なるランダム初期値を用いて7つの候補ネットワークを学習します。検証スコアが改善する場合にのみ候補をアンサンブルへ追加します。選択されたモデルの係数予測を平均し、その後にPCAの逆変換を行います。
| 場 | アンサンブル内のモデル数 | 検証スコア |
|---|---|---|
| 温度 | 4 | 0.00163856 |
| 速度U | 7 | 0.00144356 |
| 速度V | 7 | 0.00110074 |
| 速度W | 6 | 0.00127862 |
推論時には、入力、ネットワーク、係数のスケーリング、PCA基底、出力のスケーリングをすべて単一のCUDAデバイス上に保持します。全セルの場は、 torch.inference_mode()の下で係数と基底の行列積により再構成します。モデルとPCA・スケーラーのテンソルはワーカープロセス内にキャッシュします。これにより、CFD方程式を再度解くことなく、5次元の運転条件から4つの空間場を得られます。
03 / Fluentとの精度比較
外部評価には現在、 5ケース が含まれます。発熱率は15%、38%、62%、85%、92%で、空調機のON/OFF条件は以下の表に示します。各ケースには3,494,065個の流体セルが含まれます。5つの発熱率はいずれも10%刻みの学習条件には含まれていませんが、冷却構成は学習データに含まれています。この評価は、既知の冷却構成における学習済み発熱率範囲内の補間を対象としています。学習範囲外の設定や未学習の冷却構成は検証していません。追加の4ケースは、新たに提供されたテスト結果の概要に基づいています。発熱率92%の値には、以前に報告した評価結果を引き続き使用しています。
報告する指標: MAEはセルごとの平均絶対誤差、P99は絶対誤差の99パーセンタイル、MAXはセルごとの絶対誤差の最大値です。温度誤差の単位はケルビン(K)、速さの誤差の単位はメートル毎秒(m/s)です。速さは速度の大きさであり、 sqrt(u² + v² + w²)として計算します。方向別の速度成分や、ベクトル誤差のノルムではありません。これらの指標は、サロゲートモデルとFluentを比較したもので、実際のセンサー測定値との比較ではありません。GPU負荷設定は、CFDで指定した発熱率を意味します。表の値は小数点以下6桁に丸めています。
温度誤差
| GPU負荷設定(%) | ONの空調機 | OFFの空調機 | 平均絶対誤差 MAE(K) | 99パーセンタイル P99(K) | 最大絶対誤差 MAX(K) |
|---|---|---|---|---|---|
| 15 | 1, 2 | 3, 4 | 0.001052 | 0.011200 | 0.226959 |
| 38 | 2, 4 | 1, 3 | 0.000939 | 0.008789 | 0.429596 |
| 62 | 3, 4 | 1, 2 | 0.000815 | 0.008759 | 0.139923 |
| 85 | 1, 2, 3 | 4 | 0.002951 | 0.039795 | 1.151581 |
| 92 | 1, 3, 4 | 2 | 0.002242 | 0.032288 | 1.194550 |
速さの誤差
| GPU負荷設定(%) | ONの空調機 | OFFの空調機 | 平均絶対誤差 MAE(m/s) | 99パーセンタイル P99(m/s) | 最大絶対誤差 MAX(m/s) |
|---|---|---|---|---|---|
| 15 | 1, 2 | 3, 4 | 0.001119 | 0.008545 | 0.412387 |
| 38 | 2, 4 | 1, 3 | 0.000755 | 0.006119 | 1.119324 |
| 62 | 3, 4 | 1, 2 | 0.000613 | 0.004668 | 0.963135 |
| 85 | 1, 2, 3 | 4 | 0.007447 | 0.078335 | 0.803782 |
| 92 | 1, 3, 4 | 2 | 0.002131 | 0.016291 | 1.527859 |
ケースごとの最大絶対誤差
5ケースにおける温度のMAXは0.139923〜1.194550 K、速さのMAXは0.412387〜1.527859 m/sです。各値は、そのケースの流体メッシュ全体におけるセルごとの絶対誤差の最大値であり、コンター図に表示されているセルだけを対象としたものではありません。
コンター比較の読み方
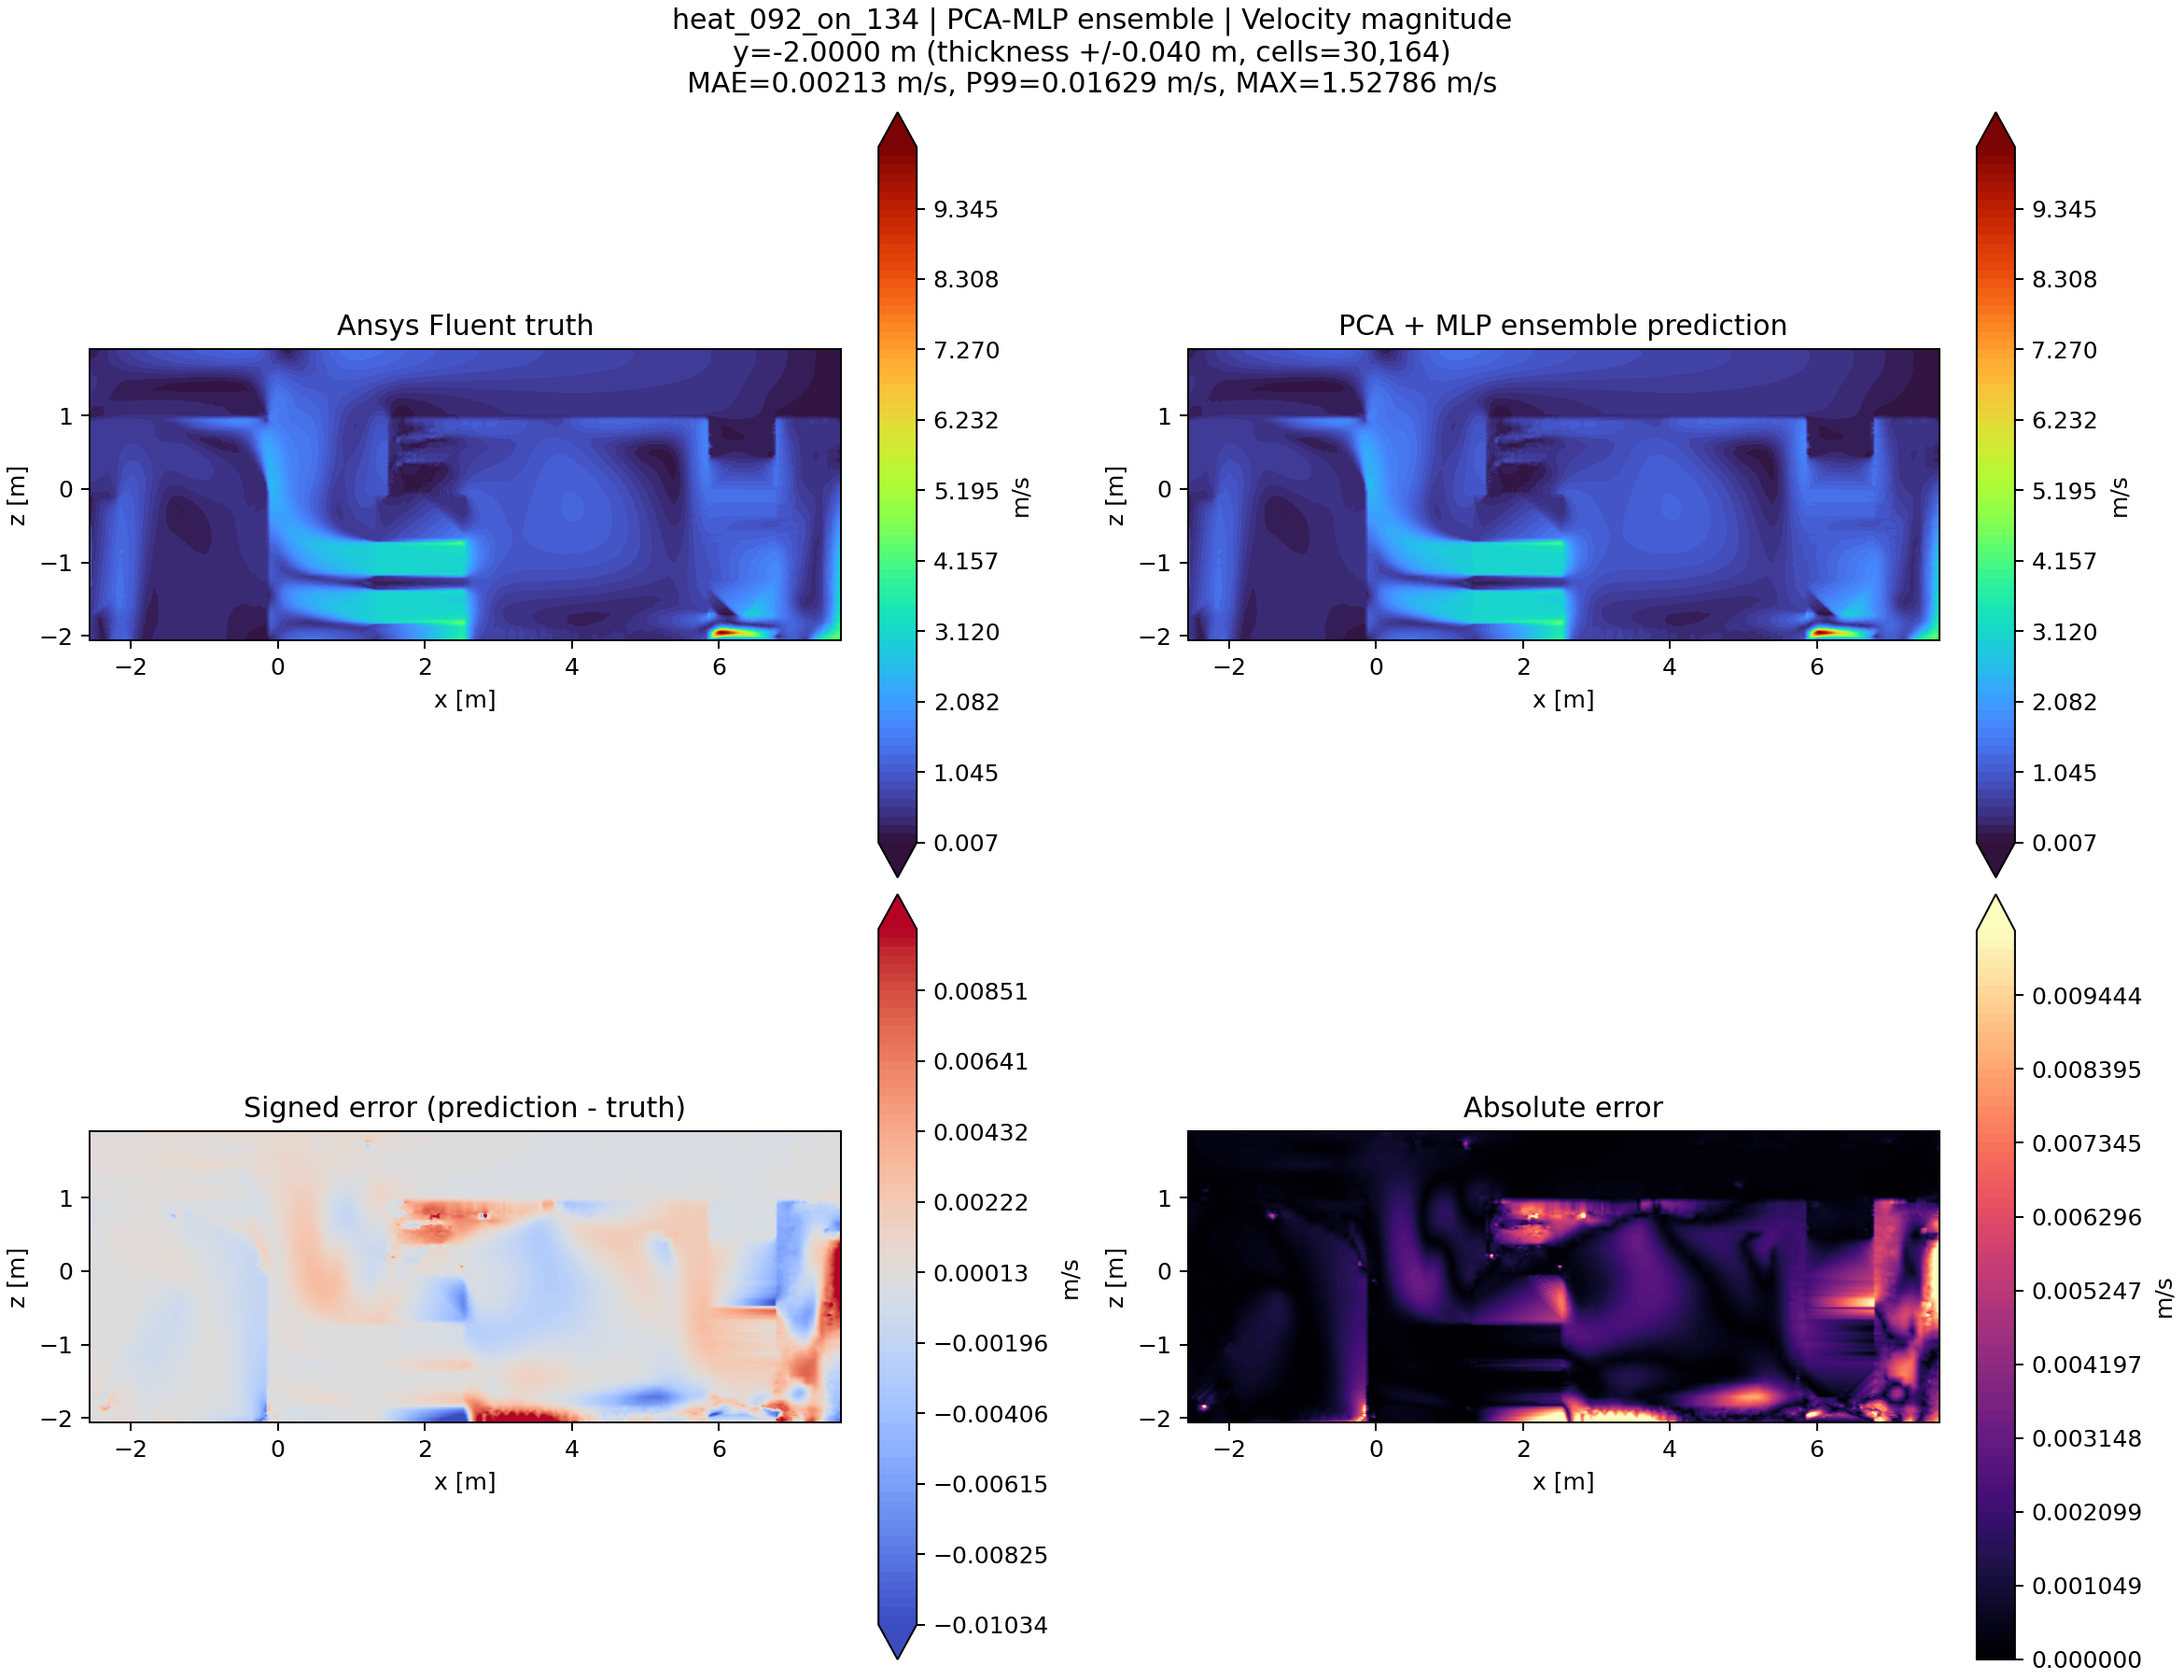
以下の4つの図は、 発熱率92%、空調機1・3・4がON、2がOFFのケースのみを示します。他の4ケースの結果は上の表に記載しています。左上から時計回りに、Fluentの参照場、サロゲートモデルの予測、絶対誤差、符号付き誤差(予測値 − 参照値)を示します。各図の参照場と予測のパネルには、共通のカラースケールを使用しています。画像の見出しに記載した値は、 全セル に対する92%のケースのMAE、P99、最大誤差です。表示したスライスだけの統計値ではありません。スライスに含めるセルは、基準面から±0.040 mの厚さで定義しています。誤差パネルの色の範囲は図ごとに異なります。
図01 / 温度・水平スライス
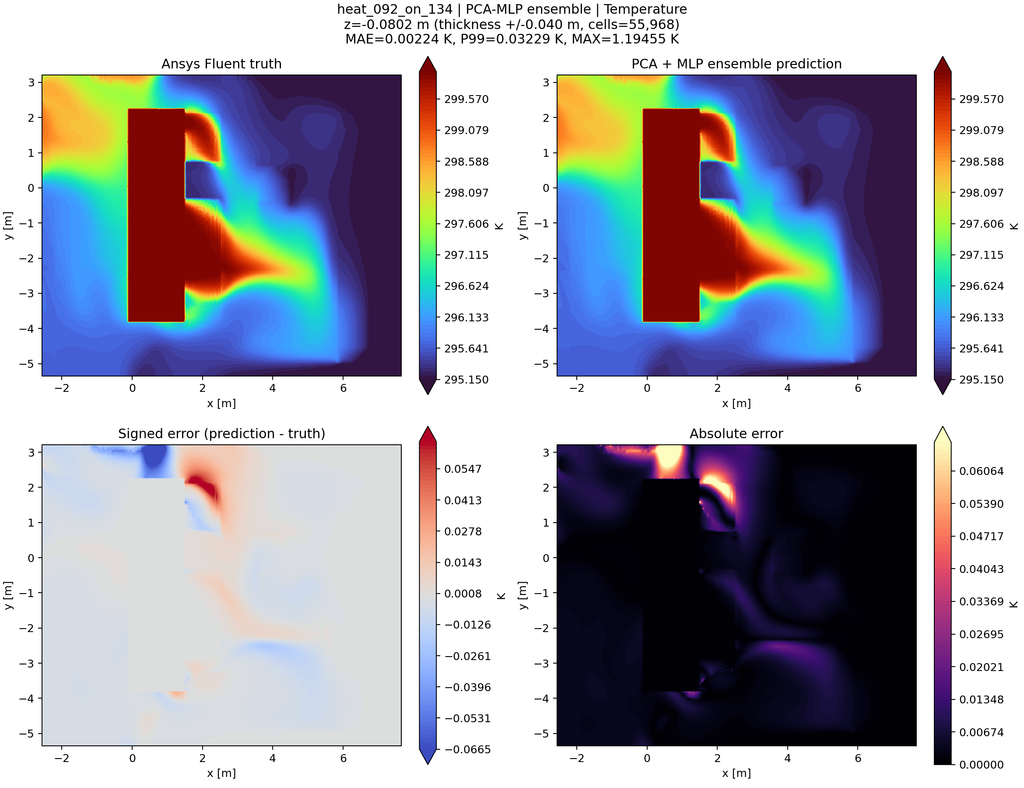
図02 / 温度・鉛直スライス
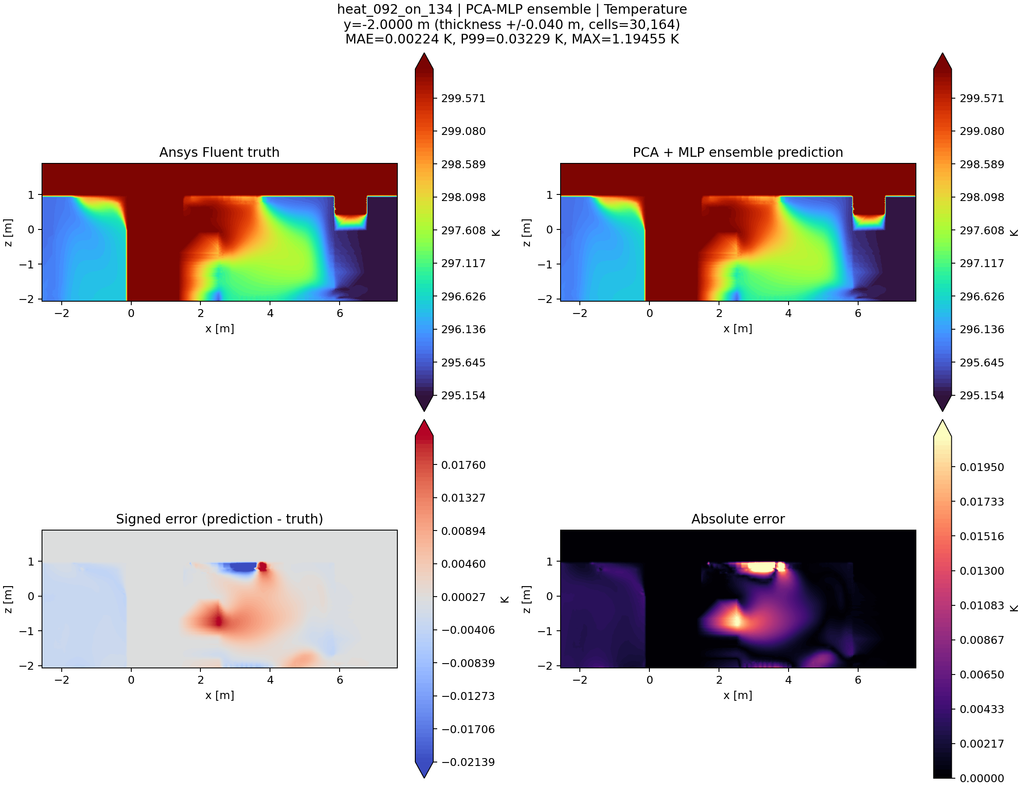
図03 / 速さ・水平スライス
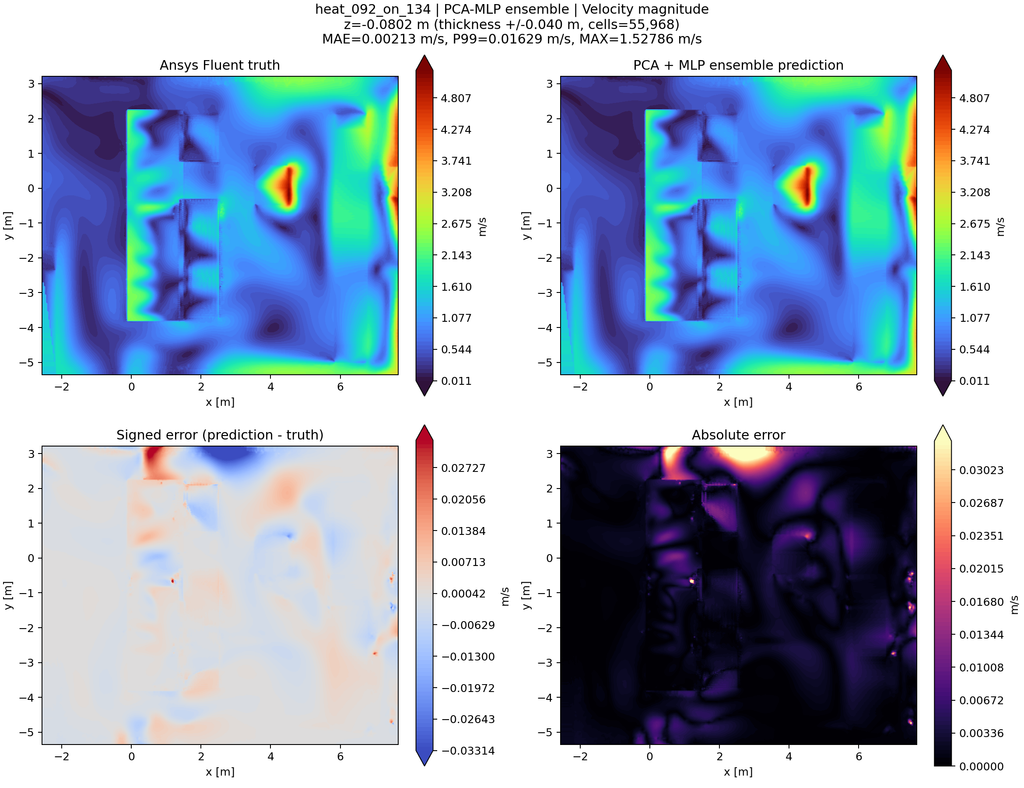
図04 / 速さ・鉛直スライス
04 / Kit-CAEによるインメモリ可視化
現在のサロゲートモデルに対するファイルベース方式では、圧縮した予測NPZを書き出し、VTKで多面体のCFDメッシュを再サンプリングし、CPU上でOpenVDBを生成してVDBファイルを保存します。そのファイルをOpenUSDのOpenVDBAsset経由で参照し、NVIDIA IndeXで使用します。温度と速度を含む実測実行では、中間の予測NPZは約86.9 MiB、温度のVDBは約17.7 MiBでした。この処理経路では、推論後もディスク入出力と形状の再サンプリングが繰り返し発生します。
図05 / ワークフローの比較
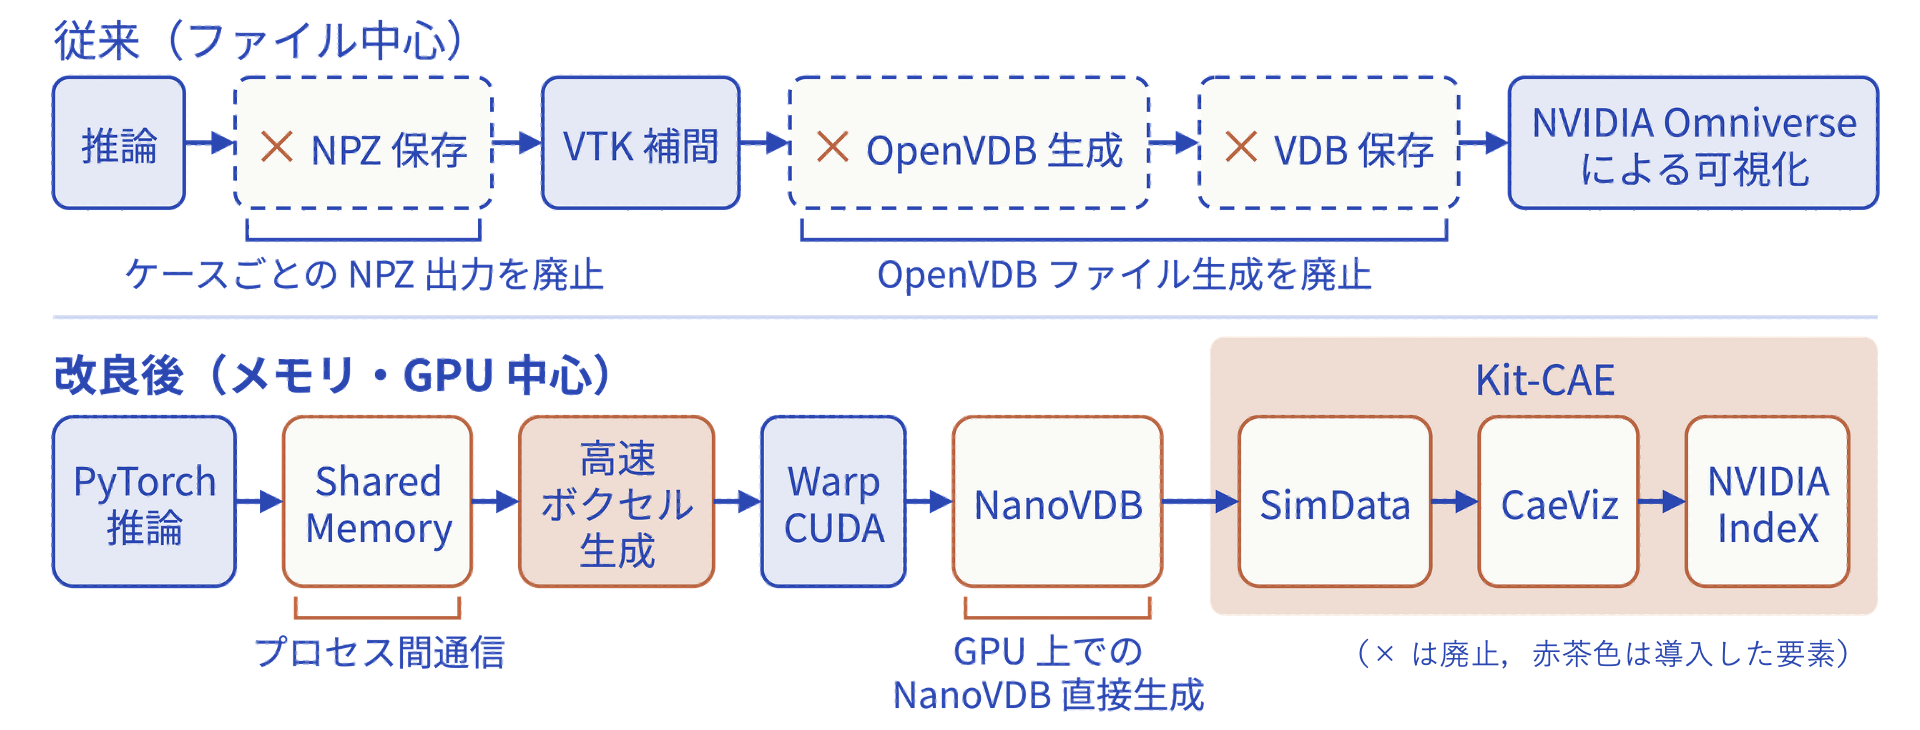
インメモリ拡張機能では、PyTorch/CUDAをKitのABIから分離するために、独立したPython推論ワーカーを使用します。制御メッセージはJSON Linesで交換します。これにより、更新ごとのNPZとVDBによるデータ受け渡しを回避します。拡張機能が提供するのは、独自の MemoryVolumeAdapterです。組み込みアダプターをそのまま使用しているわけではありません。USD primの属性 ikulab:memoryDatasetId で、プロセス内のレコードを識別します。温度はWarpボリュームとして、速度成分と有効性マスクはGPU上の場として公開します。Kit-CAE / warp-simdata のAPIは、データセット、場、アダプターのインターフェースを提供します。サロゲートモデルの学習やCFD方程式の求解は行いません。CaeVizは、ボリューム、平面スライス、流線、流れのアニメーションの各オペレーターを作成し、NVIDIA IndeXを通じて描画します。インメモリのデータセットが変更された場合、拡張機能は使用中のコントローラーを明示的に無効化・同期します。ファイルパスが変わらないため、自動更新が発生しないからです。
拡張機能のインターフェースと可視化
拡張機能UI / サロゲートモデルの操作
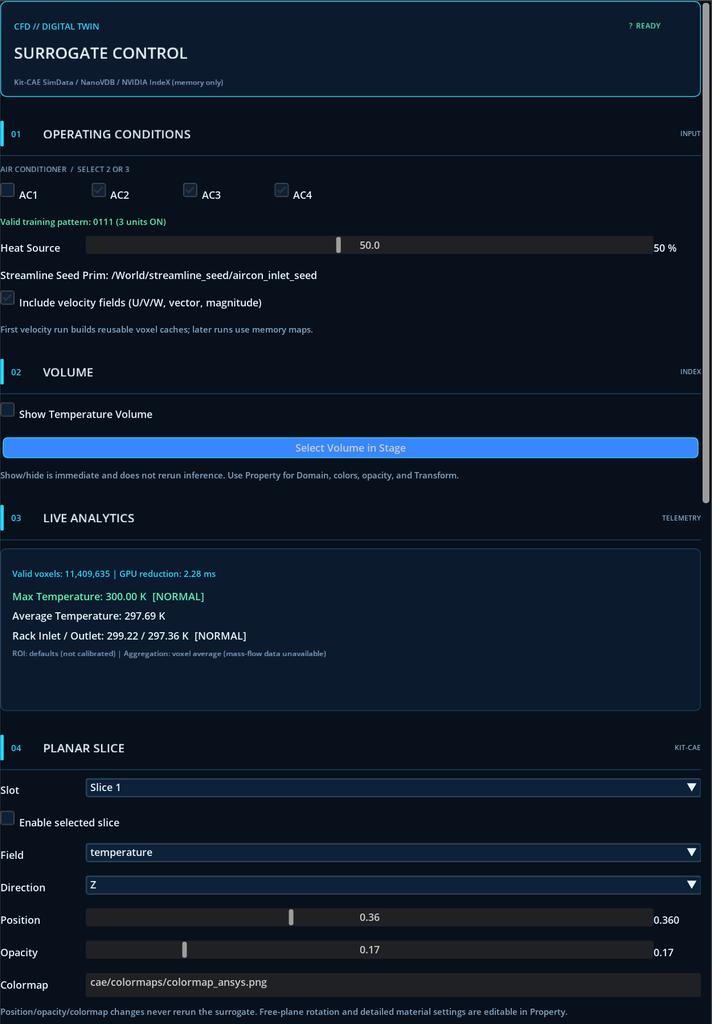
運転条件入力から3D表示へ
運転条件
CFDの発熱率で表されるGPU負荷レベルを設定し、4台の空調機それぞれのON/OFF状態を選択します。気流を可視化するために、速度場を含めることもできます。
可視化の操作
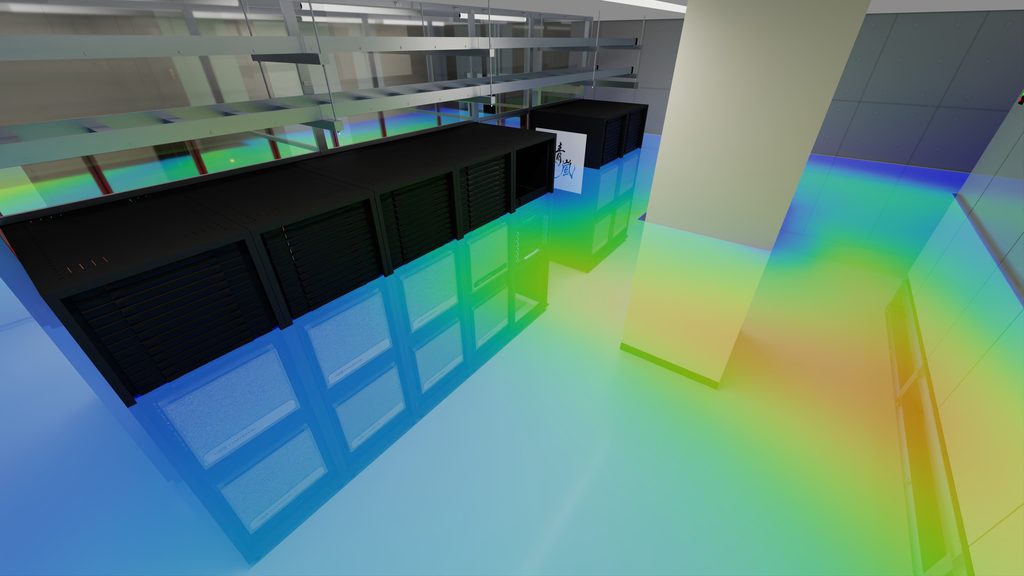
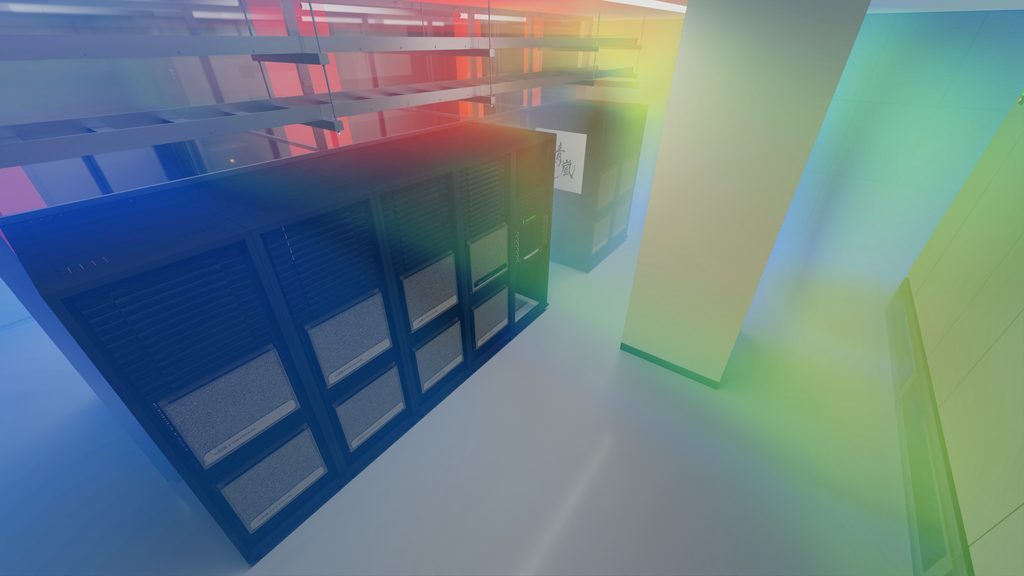
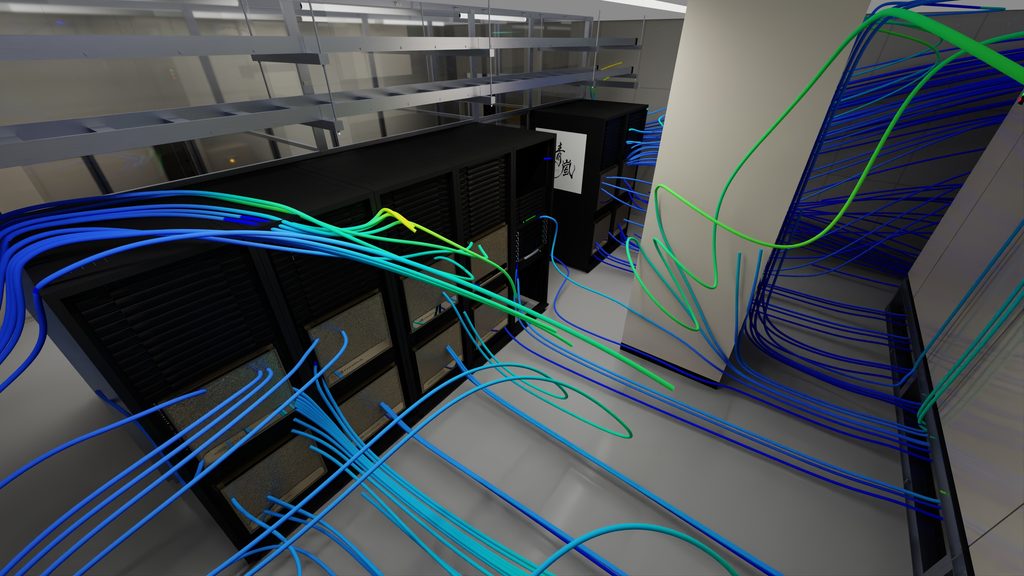
温度ボリュームの表示を切り替え、平面スライスの場、方向、位置、不透明度を設定します。拡張機能には、気流を可視化するための流線と流れのアニメーションの設定もあります。
リアルタイム分析
パネルには温度の要約情報も表示されます。スクリーンショットはインターフェースを示したものであり、追加の精度評価やレイテンシのベンチマークではありません。
スライス
ボリューム
流線
アフィンボクセルキャッシュ
メッシュと補間格子が固定されている場合、PCAによる再構成は予測係数に対してアフィンであり、セルからボクセルへの補間は線形です。そのため、補間演算子 V をバイアスと各PCA基底に一度適用しておけば、新しい条件ごとにボクセル化済みの基底を組み合わせることができます。
cell_field = bias + Σᵢ cᵢ · basisᵢ
voxel_field = V(cell_field) = V(bias) + Σᵢ cᵢ · V(basisᵢ)
各物理場には9つの係数と1つのバイアス列があります。格子サイズは343 × 288 × 134で、格子点数は13,237,056です。間隔は0.03 mで、有効ボクセル数は11,409,635です。4つの場のアフィンキャッシュは2,170,880,292バイト(約2.02 GiB)を占めます。各物理量について、補間済みのバイアスと9つの基底場を保存し、以後の更新で再利用します。メッシュ、ボクセルサイズ、モデルのシグネチャが変わった場合は、該当するキャッシュを再構築する必要があります。
Warpは、 wp.Volume.allocateを用いて、インデックス空間のNanoVDBをGPU上に確保します。float32の値をCUDA配列にアップロードし、起動したカーネル内で wp.volume_store_fを用いてボクセルを書き込みます。USDの変換によって、物理空間での配置と0.03 mのスケールを与えます。その後、SimData/CaeVizの橋渡し機構が、VDBファイルへの書き出しと読み込みを行わずに、GPU上の場を描画します。
05 / エンドツーエンドのレイテンシ
測定には、発熱率92%、空調機1・3・4がON、2がOFFのケース、NVIDIA RTX PRO 6000 Blackwell Max-Q、前述の0.03 m格子、同じPCA/MLPアンサンブルを使用しました。各条件の初回実行を「コールド」として報告します。「ウォーム」の各結果は、初回を除く、その後の10回の実行の平均です。ファイルベース方式とインメモリ方式の4場の結果には、いずれも温度と3つすべての速度成分が含まれます。
| 条件 | コールド総時間 | ウォーム平均(10回) | ウォーム標準偏差 | ウォームP95 |
|---|---|---|---|---|
| ファイルベース方式、T+U/V/W | 29.402秒 | 13.342秒 | 0.458秒 | 14.195秒 |
| インメモリ方式、温度のみ | 7.851秒 | 0.448秒 | 0.042秒 | 0.527秒 |
| インメモリ方式、T+U/V/W | 56.290秒 | 1.552秒 8.60倍高速 | 0.161秒 | 1.703秒 |
同一条件でのウォーム比較
4つの場を対象としたウォームのエンドツーエンド平均時間は、ファイルベース方式が13.342秒、インメモリ方式が1.552秒で、インメモリ方式は 8.60倍高速です。可視化経路の平均時間は、ファイルベース方式が9.259秒、インメモリ方式が1.300秒で、インメモリ方式は 7.12倍高速です。4つの場のコールド総時間は、ファイルベース方式が29.402秒、インメモリ方式が56.290秒でした。後者のコールド実行では、3つの速度成分のアフィンキャッシュの準備に45.599秒を要しました。
図06 / ウォーム処理時間の比較
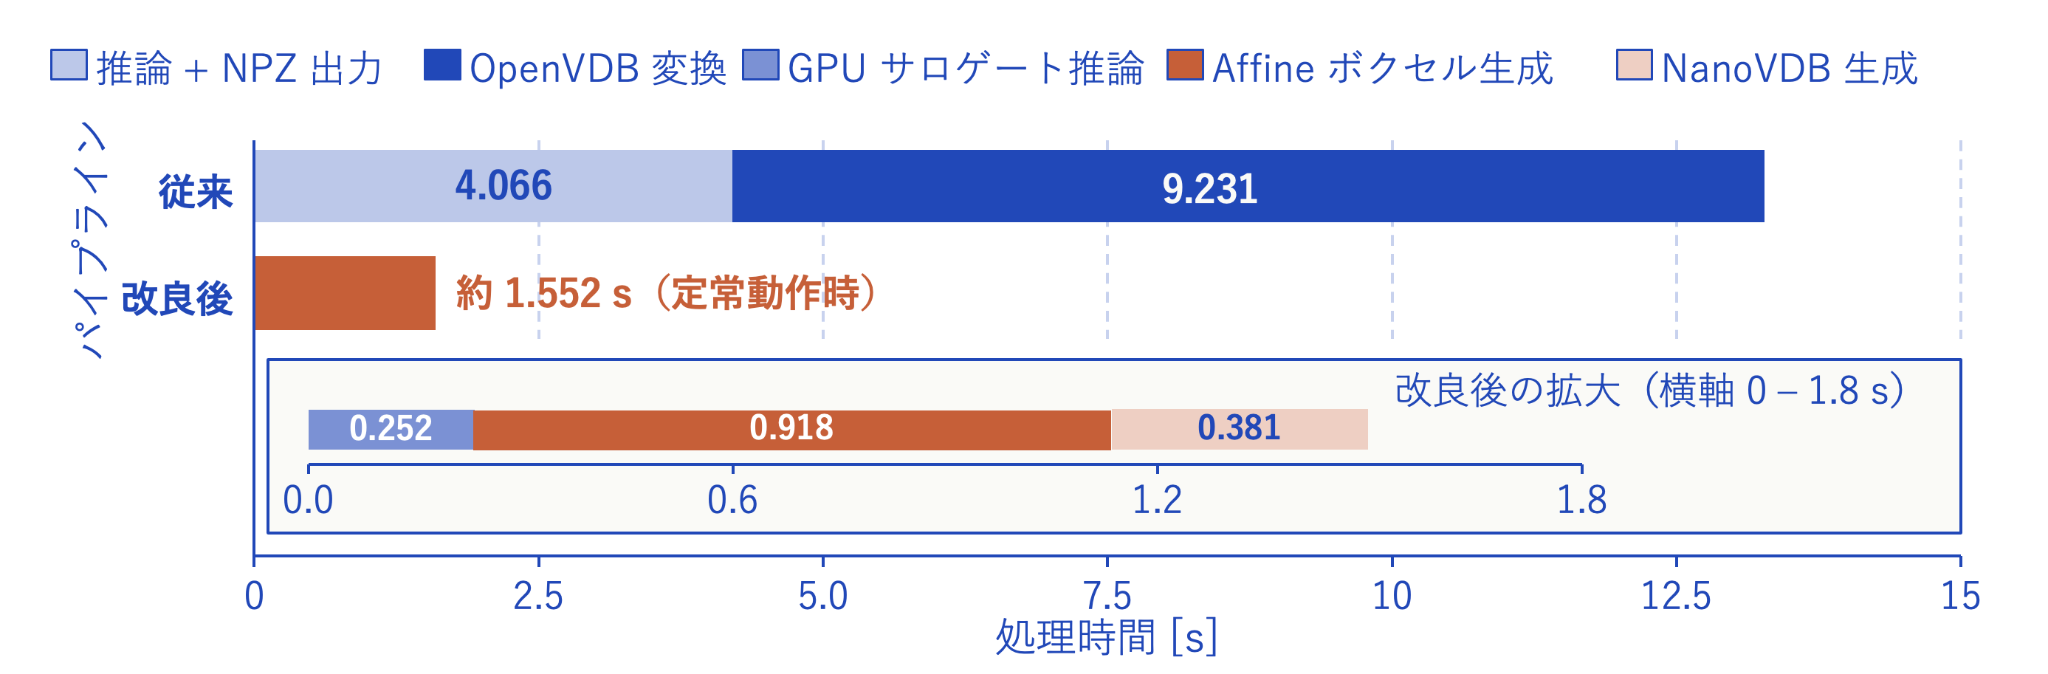
| ウォームの段階別平均 | ファイルベース方式、T+U/V/W | インメモリ方式、T+U/V/W |
|---|---|---|
| 推論、および/またはNPZ出力 | 4.066秒 | 推論:0.252秒 |
| VTK+OpenVDB / ボクセル生成 | 9.231秒 | アフィン再構成:0.201秒、温度NanoVDB:0.034秒、速度ボクセル生成:0.628秒 |
| 場のアップロード+オペレーター同期 | USD/IndeX段階:0.027秒 | アップロード:0.056秒、同期:0.149秒 |
| 可視化経路全体 | 9.259秒 | 1.300秒 7.12倍高速 |
| エンドツーエンド | 13.342秒 | 1.552秒 8.60倍高速 |
インメモリ経路で温度のみを対象とした場合、ウォーム平均は0.448秒でした。報告された段階別平均は、推論が約0.042秒、再構成が0.140秒、NanoVDB生成が0.044秒、場のアップロードが0.016秒、オペレーター同期が0.148秒です。エンドツーエンド平均には、測定やその他のオーバーヘッドも含まれます。この条件は温度のみを対象とし、4つすべての場を対象としたものではありません。
個々の可視化操作は、それぞれ1回ずつ測定したもので、10回の平均ではありません。スライス作成は1.059秒、スライス位置の更新は0.0317秒、流線作成は0.782秒、流れのアニメーション作成は0.0345秒でした。これらの時間にはスクリーンショットの取得は含まれません。
06 / 実験環境と限界
記録されたワークステーションは、Windows 11 Enterprise、Intel Core i9-13900K、約127.8 GiBの物理RAM、NVIDIA RTX PRO 6000 Blackwell Max-Qを搭載していました。GPUメモリはPyTorchの報告値で95.6 GiB、ドライバーは591.86です。学習パイプラインの記録ではPython 3.13.3を使用しています。データセットのNPZは7,197,785,544バイト(約6.70 GiB)、4つの場のアフィンキャッシュは約2.02 GiBです。
記録されたパイプラインでは、100ケースのデータセット構築に308.560秒、PCA/MLP段階に253.165秒を要しました。これらは各段階の測定値であり、アンサンブル学習全体のエンドツーエンド測定ではありません。約3,012秒の成果物作成のタイムラインには、温度モデルの再学習と処理の調整に伴う待機時間も含まれます。
評価範囲と限界
- 外部比較: 5つの発熱率(15%、38%、62%、85%、92%)をFluentと比較しました。各ケースの冷却構成は学習データに含まれています。未学習の冷却構成や学習範囲外の設定は、これらのテストの対象ではありません。
- 局所的な誤差統計: ケースごとの温度の最大絶対誤差は0.139923〜1.194550 K、速さの最大絶対誤差は0.412387〜1.527859 m/sです。報告した評価は、安全性やホットスポット制御の判断を検証するものではありません。
- 可視化格子: 表示するボリュームには、元のFluentの非構造メッシュではなく、0.03 m間隔で再サンプリングした規則的なボクセル格子を使用しています。上記の精度指標は、再サンプリングしたボクセルではなく、元の流体セルで計算しています。
- 初期化とキャッシュ: インメモリ方式で4つの場を対象としたコールド総時間は56.290秒で、アフィンキャッシュは約2.02 GiBを占めました。メッシュ、格子、モデルのシグネチャが変わると、該当するキャッシュは無効になります。
- 未実証の機能: 測定では、Fluentに対するサロゲートモデルの誤差と、可視化更新の処理時間を報告しています。センサーデータの同化、閉ループの冷却最適化、厳格なリアルタイム期限への適合は実証していません。
下の動画は、Kit-CAE拡張機能のインターフェースを示しています。本記事の精度とレイテンシの数値は、報告したテストに基づくものであり、動画から測定したものではありません。
報告結果と適用範囲
本実装は、GPU負荷設定と4台の空調機のON/OFF状態から、3,494,065個の流体セルにおける温度と3成分の速度を再構成します。外部精度評価は、5つの補間ケースを対象としています。温度のMAEは0.000815〜0.002951 K、速さのMAEは0.000613〜0.007447 m/sです。ケースごとのP99とMAXは、精度評価の表に記載しています。コンター図とレイテンシのベンチマークは、引き続き発熱率92%、空調機1・3・4がONのケースを対象としています。このレイテンシのベンチマークにおける4場のウォームのエンドツーエンド平均時間は、ファイルベース方式が13.342秒、インメモリ経路が1.552秒で、いずれも10回の平均です。インメモリ方式は 8.60倍高速です。対応するコールド総時間は29.402秒と56.290秒でした。精度比較にはFluentを参照として使用し、学習した発熱率範囲内の既知の冷却構成を対象としています。リアルタイムのセンサー連携、閉ループ冷却制御、厳格なリアルタイム期限への適合は実証していません。
参考資料
プラットフォームの背景については、NVIDIAの Kit-CAEユーザーガイド、 Kit-CAE拡張機能のアーキテクチャ、 Warp SimDataリポジトリを参照してください。Kit-CAEは工学データの可視化フレームワークを提供し、Warp SimDataはシミュレーションデータ処理のインターフェースを提供します。ここで説明したサロゲートモデルとメモリアダプターは、本プロジェクト固有の実装です。これらの参考資料は、プラットフォームのツールについて説明するものです。本記事で報告した精度と処理時間は、本プロジェクト固有の測定値であり、これらの参考資料に記載されたプラットフォームのベンチマーク結果ではありません。