
本記事は、Character Creator 5(CC5)のカスタムキャラクターをNVIDIA Tokkioのアバターとして動かすための2本の記事のうち、2本目です。出発点は、第1部の引き渡しパッケージ[1]です。終着点は、アバターがブラウザ上で日本語の会話をこなす状態です。実際にこのアバターは、2026年9月のライブイベントで、2日間にわたり日本語で会話しました。
私たちはTokkio 5.0 GA(一般提供版)[2]を動かし、NVIDIAのコンテナイメージは出荷時のまま使いました。そのうえで、ACE Controllerの背後にある言語モデル(LLM)と音声合成(TTS)のサービスを、自前のものに置き換えました。私たち自身の測定値には、サンプル数と日付を付けています。NVIDIAのコンポーネントの性能数値は掲載しません。
1. ランタイムの成果物を定義する
私たちの完了の定義は、ブラウザ上でアバターと日本語で会話ができ、リップシンクも合っている状態でした。起動時チェックは、すべて通る必要がありました。レンダラーは、少なくとも12時間の長時間稼働試験(soak)を、再起動なしで乗り切る必要がありました。そして、ターン内の無音が5秒を超えて続いてはなりませんでした。
Runningは準備完了ではありません。すべてのpodがRunningと表示しているのにステージが機能していない状況を、私たちは実際に経験しました。2026-09-17の時点で起動時チェックは48項目あり、イベントに持ち込んだリビジョンで、そのすべてに合格しました。一方で、残っている穴もあります。本番に出したレンダラーのバイナリそのものには、連続12時間の稼働記録がありません。そして、5秒の上限に照らしてターン全体の時間を端から端まで計ったことは、一度もありません(第11節)。
2. スタックのバージョンを固定する
2026年9月の時点で、公開されているTokkioの最新リリースは5.0 GAで、そのドキュメントはアーカイブサイトに移っています。そのため、すべてのバージョンを固定してください。
| コンポーネント | 使用したもの |
|---|---|
| Tokkioアプリのchart | tokkio-1stream-with-ui 5.0.0-GA、one-clickインストール、シングルノード、ベアメタル |
| ACE Controller | 5.0.0、pipecat 0.0.68 [2] |
| Audio2Face-3D(A2F-3D) | 1.3.16 [3] |
| Riva | 2.19.0、ja-JPのストリーミングConformerに差し替え(第7節) |
| Unreal Rendererマイクロサービス | 0.1.3 |
| Unreal Engineのビルド | 5.5.4、Linux、Development構成 |
| Video Storage Toolkit(VST、VMSとも呼ばれます) | 1.3.0 |
| Animation Graph | 1.1.0 |
| Kubernetes | kubeadm 1.31.2, containerd 1.7.23 (cgroup v2上でsystemd cgroupドライバーを使用) |
| GPU Operator | v24.9.2, NVIDIA Container Toolkit 1.17.4、Container Device Interface(CDI)は無効 |
| ホスト | Ubuntu 22.04 LTS、カーネル5.15、2x NVIDIA RTX 6000 Ada Generation |
NVIDIAのUnreal向けACEプラグインはUnreal Engine 5.3向けにビルドされており、ほかのバージョンでは再ビルドが必要です[4]。レンダラー作者が、私たちの5.5.4のビルドに合わせて再ビルドと修正を行いました。
3. ACE Controllerは残し、その背後を置き換える
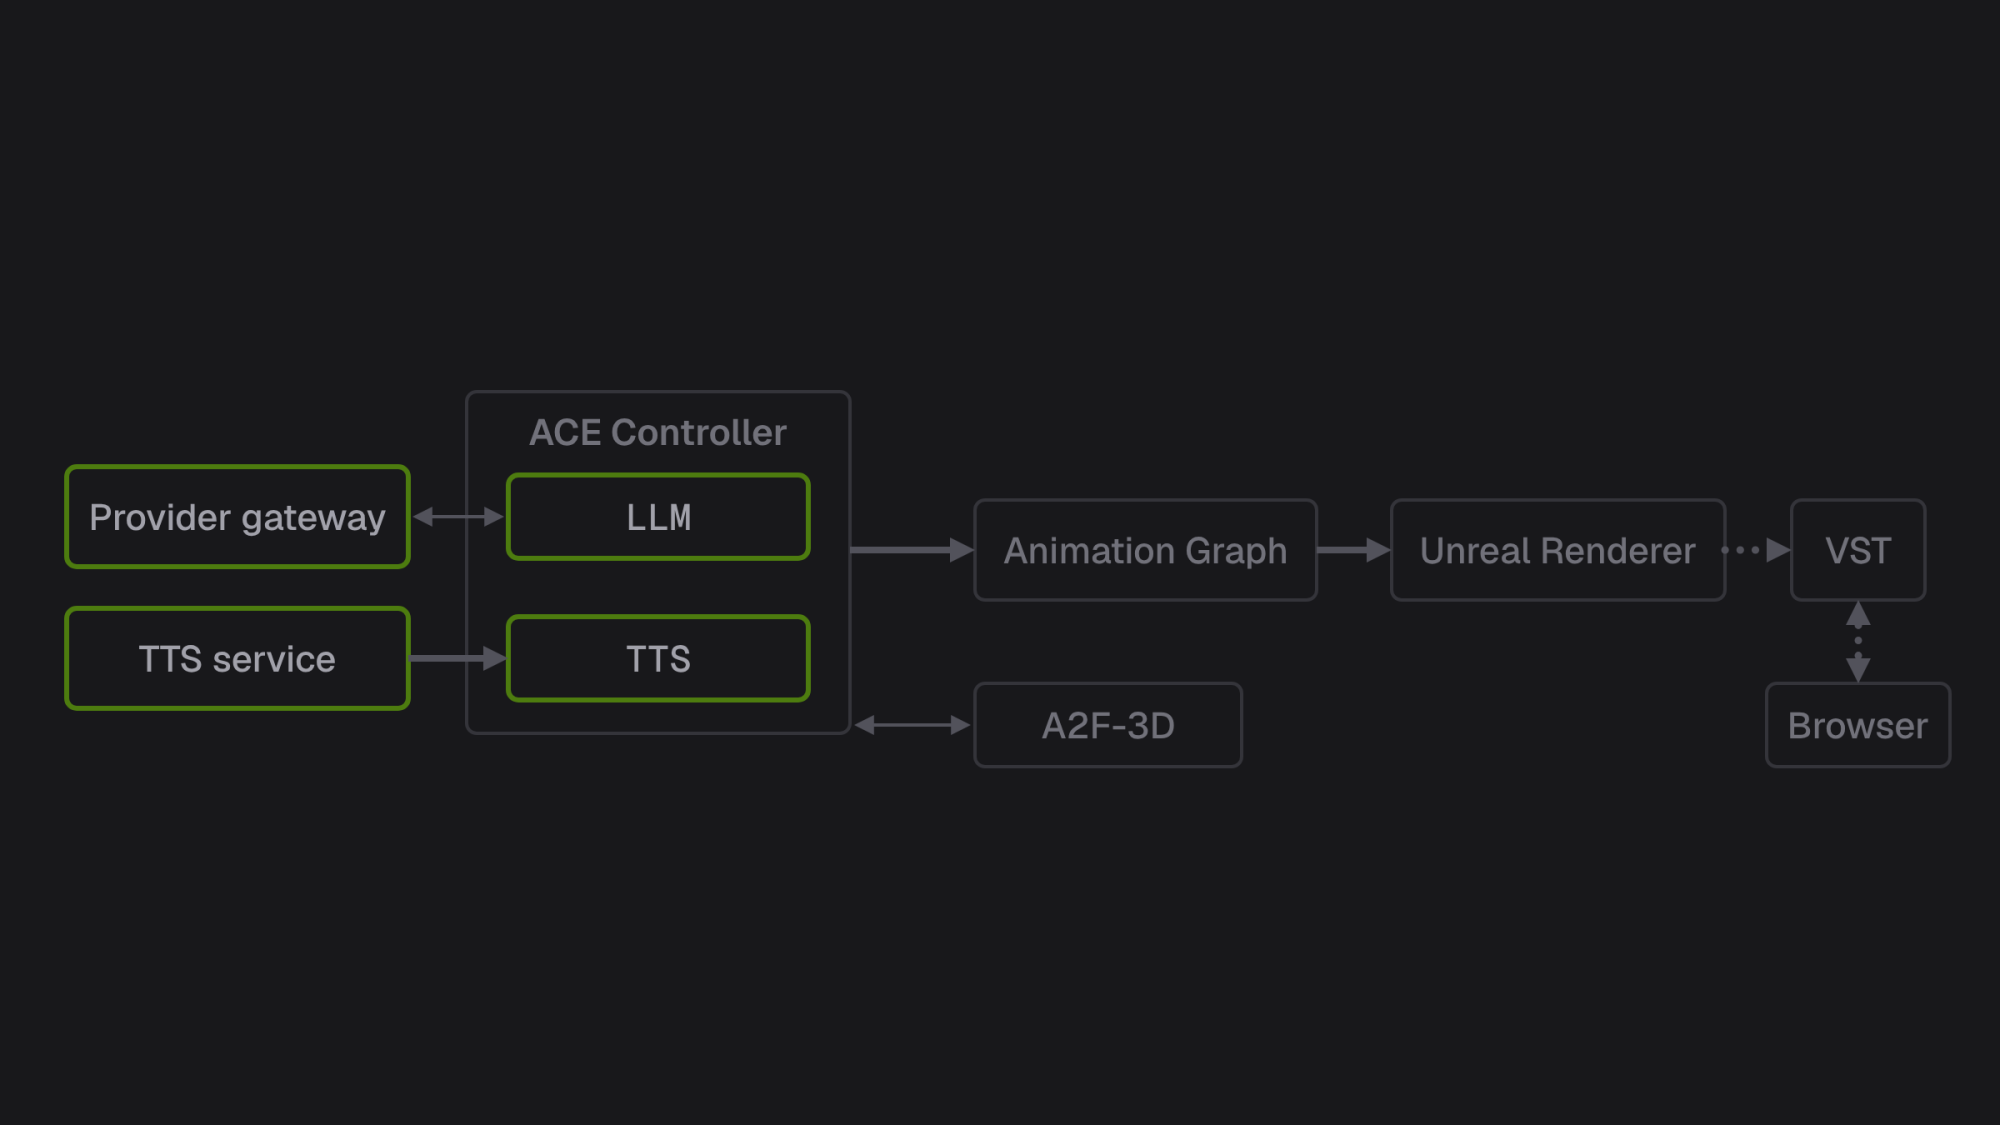
ACE Controller、Riva、Audio2Face-3D、Animation Graph、レンダラー、Stream Distribution and Routing(SDR)、VST、UIはすべて標準のイメージのまま動いています。コントローラーは回答の音声をAudio2Face-3Dに送り、そのアニメーションはAnimation Graphを経由してレンダラーに届きます[5]。私たちが置き換えたのは、コントローラーの背後にあるLLMとTTSです(図 1)。
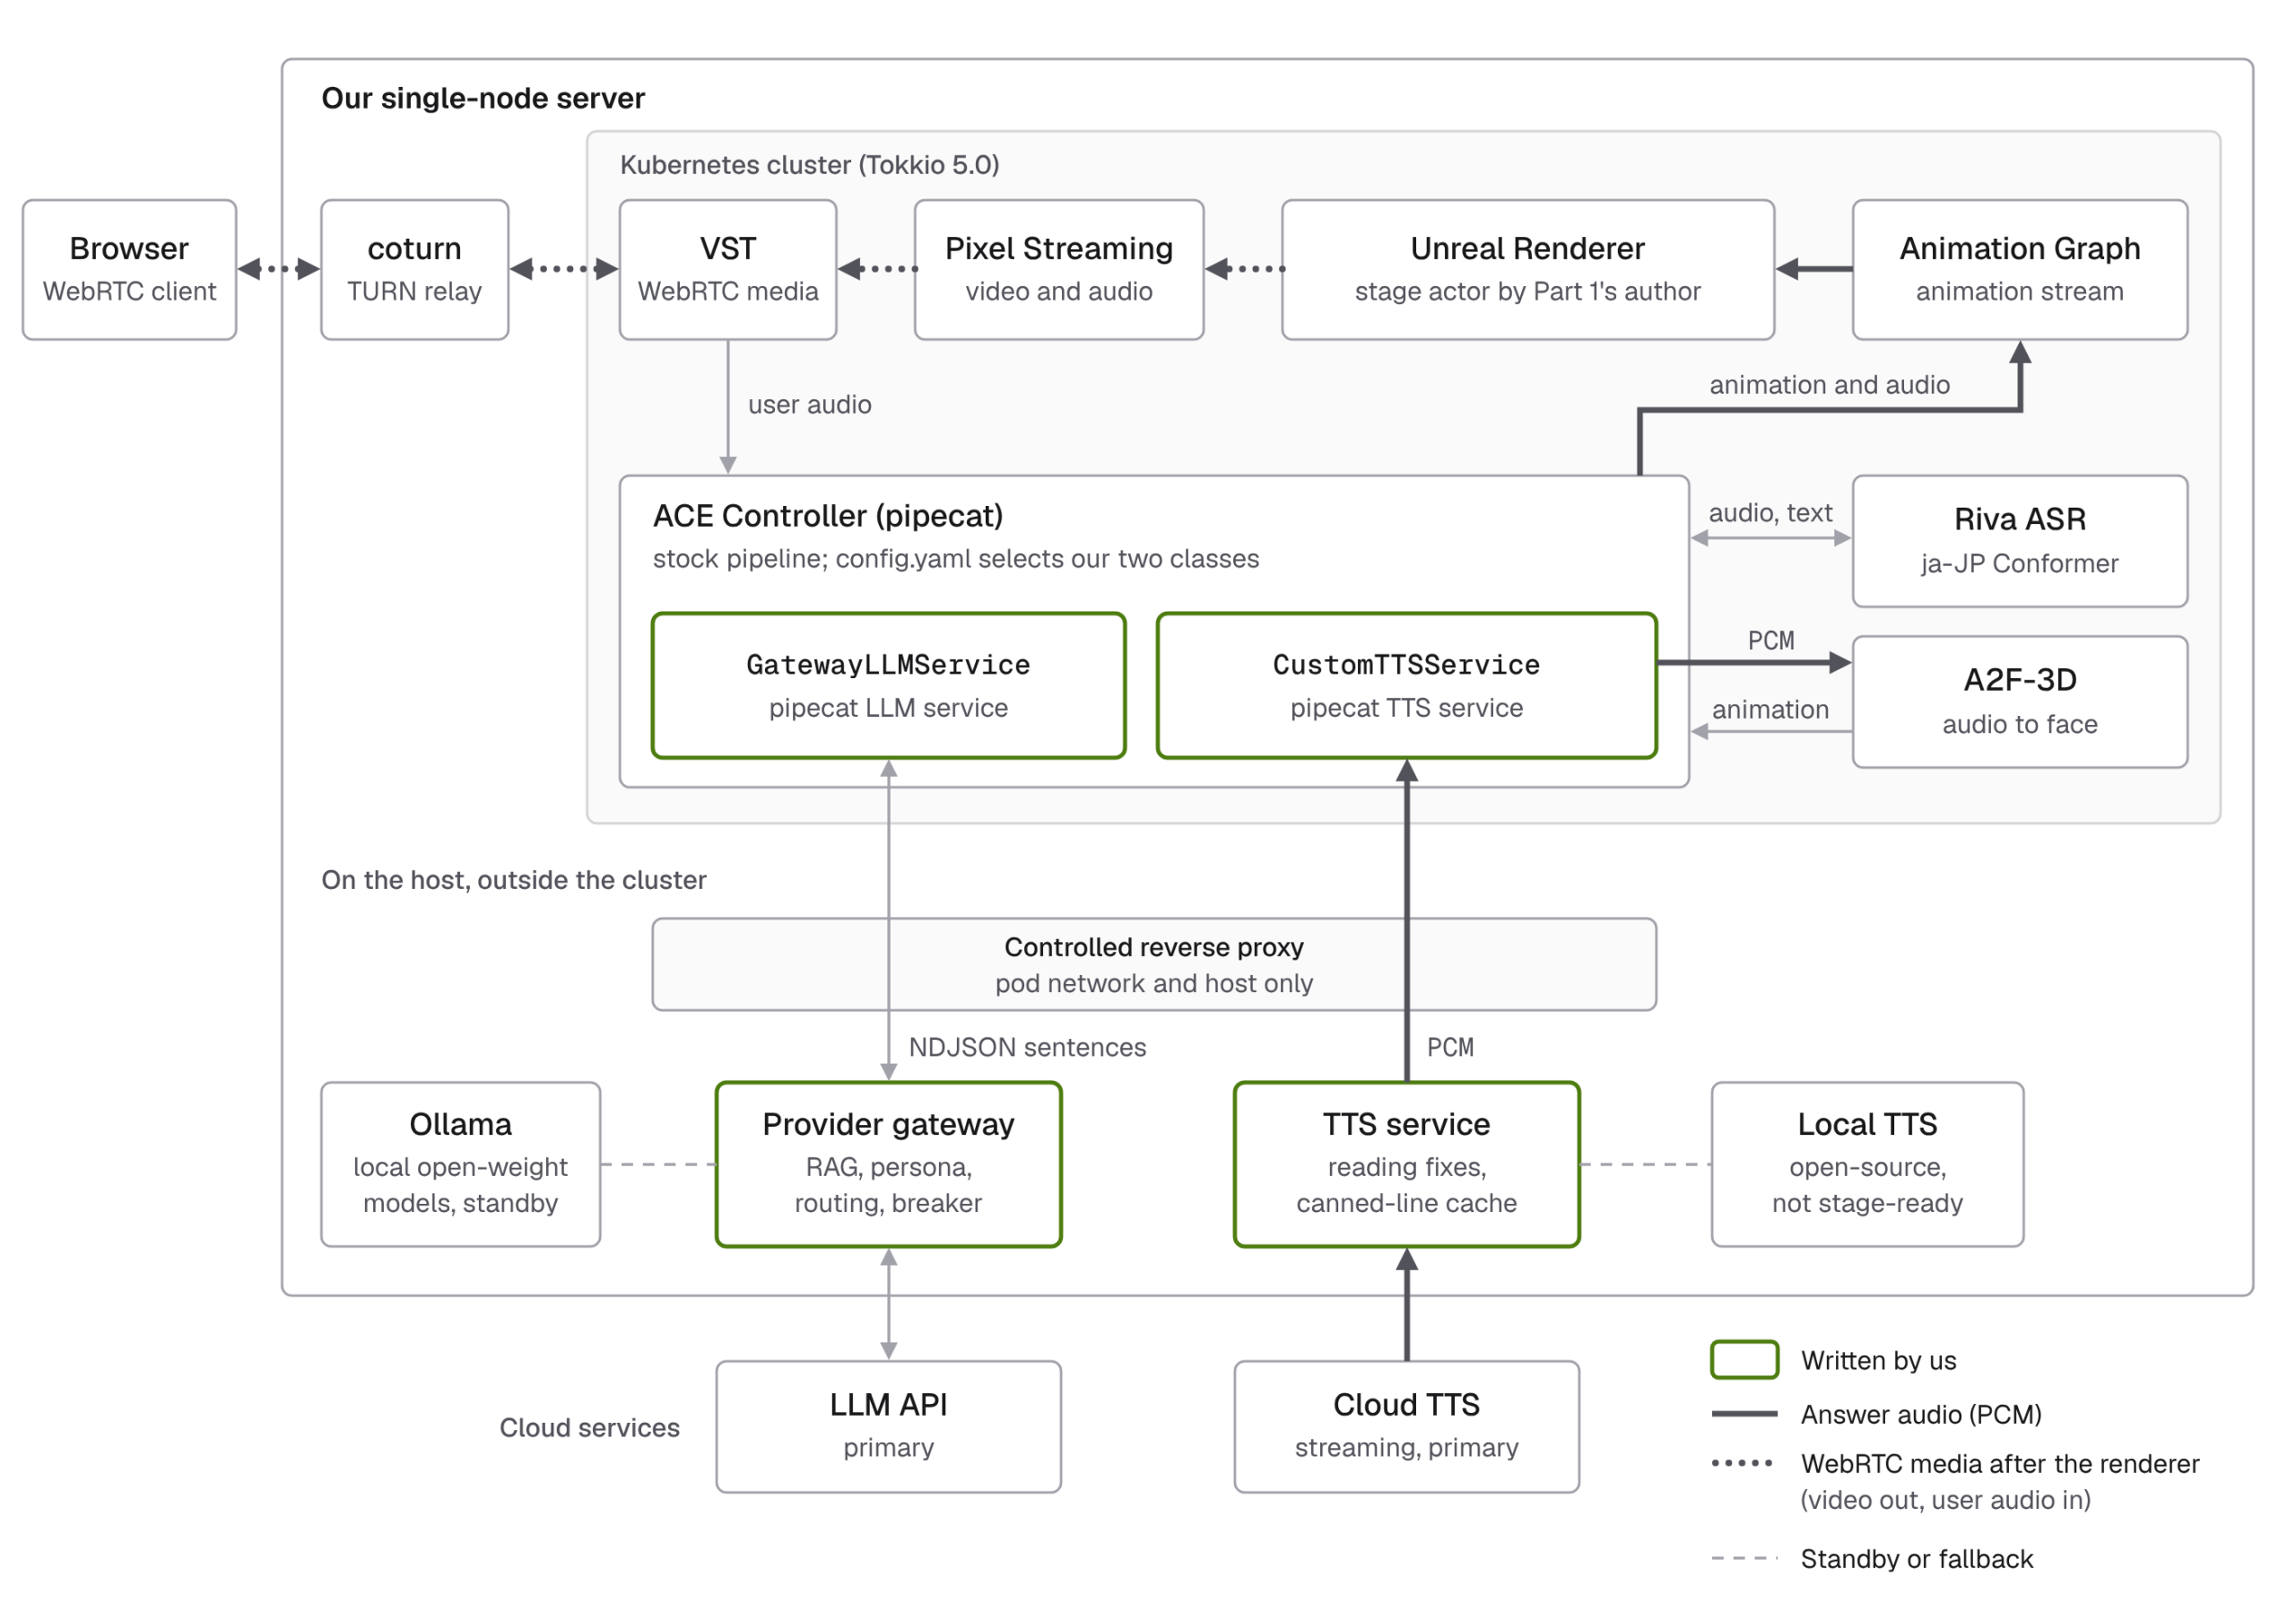
コントローラーは、pipecatにNVIDIAの拡張であるnvidia-pipecatを加えたものです[6]。そのコードと設定は、/codeにマウントされたPersistentVolumeClaim上にあります。NVIDIAのドキュメントでは、LLMはconfig.yamlのllm_processorで、ほかのプロセッサーはbot.pyの編集で差し替える方法が説明されています[7]。実際には、llm_processorが受け付けるのは標準の3つのクラス名だけで、出荷時のbot.pyは標準のクラウドTTSを無条件に構築します。そのTTSのキーがない環境では、文字起こしは出ても声は出ません。私たちはコントローラーのボリューム上で、config.pyに私たちのクラス名とtts_processorキーを追加しました。bot.pyは、私たちのクラスを構築し、その設定セクションがないときは明示的にエラーで止まるように変更しました。同じファイルでは、Rivaの言語とモデル、音声区間検出(VAD)のパラメーター、自動音声認識(ASR)の単語リストも設定しています。
私たちのprovider gatewayとTTSサービスはホストのループバックで待ち受けていますが、コントローラーのpodからはそこに届きません。ホスト上のリバースプロキシがそこへ転送し、podネットワークとホスト自身だけを通し、ストリーミングのためにバッファリングを無効にしています。これはネットワークの分離であって、認証ではありません。gatewayはまずクラウドのLLM APIを呼び、Ollamaで動かすローカルのオープンウェイトモデル(32Bの主系と7Bの待機系)をフォールバックにしています。gatewayは1文ごとに改行区切りJSON(NDJSON)を1行出力するので、モデルがまだ書いている間に、最初の文からTTSが始まります。私たちのTTSサービスは、クラウドのストリーミングTTSサービスを呼びます。
コントローラーのボリュームは、gitとレビューのどちらの管理下にもありません。そのため起動時チェックは、注入した各モジュールのハッシュをリリースと照合し、bot.pyが各クラスを構築していることを確認します。初回の実行では、リリースからずれたモジュールが2つ見つかりました。
4. パッケージ化されたレンダラーを、ランタイム契約として受け入れる
レンダラーのパッケージも、第1部の著者が作りました。このパッケージには、stage actor、表情のマッピング、NVIDIAのUnrealプラグインへのパッチが含まれます。レンダラー作者は、以前のWindows版のパッケージとモックのAnimation Graphを使って、HTTPによるストリームの登録と解除、および表情アニメーションの受信経路を検証しました。以前のLinux版のパッケージはビルドと転送の完全性までを検証し、その後のLinux版のビルドはLinuxのGPU上で起動と描画までを確認しています。本記事では、受け入れ検証の残りを扱います。対象となるのは、私たちのサーバーのTokkio内での動作、実際のAudio2Face-3Dの出力と対話、WebRTC経由のブラウザでの映像と音声、長時間の稼働です。
stage actorは毎フレーム、補間済みのACEの重みを読み取り、52個のACE入力を62本のアニメーションカーブに対応づけます。専用のAnimInstanceが、アニメーションプロキシを通じてそのカーブを出力します。続いて、キャラクターのReallusion Rig Logicのポストプロセス用Animation Blueprintが、それらをモーフターゲットと、顎と目のボーンのポーズに変換します。
第1部の第7節では、同じ52個の入力を54個のCC5ターゲットに対応づけています[1]。口に関する4つの入力で出力が増えており、出力の名前はキャラクターの表情プロファイルに従います。
| ACEの入力 | 第1部での出力数 | 本番用ビルドでの出力数 |
|---|---|---|
| MouthFunnel | 1 | 4(象限ごとに1つ) |
| MouthPucker | 1 | 4(象限ごとに1つ) |
| MouthRollLower | 1 | 2(左と右) |
| MouthRollUpper | 1 | 2(左と右) |
これで出力が8個増え、54が62になります。2つの入力は近似です。MouthCloseは唇を引き締める形状を動かすので、唇が閉じることは保証されません。MouthShrugUpperは近似的なコントロールに対応します。MouthShrugLowerは、キャラクターに既存のボーン駆動のポーズを使います。この対応づけは、以前のレンダラーのビルドから来たものです。本番用ビルドを含む後のビルドでは、同じ対応づけを新しいアクタークラスに移しました。起動時の本番用ビルドのログでは62個のバインディングがすべて解決していますが、それはすべての表情や実際の発話の見た目が正しいことを意味しません。
以下の毎フレームの処理は、その以前のレンダラーのビルドからの抜粋で、ログ出力と検証のコードは省略しています。
実行時には、stream helperのGetActor()が返すアクターが、UACEAudioCurveSourceComponentを持っていなければなりません[4]。これがないと、ビルドは正常に見えても、SDRのadd_streamにHTTP 400と「Failed to subscribe character to stream!」を返します。その後ブラウザには映像のない音声だけが届き、やがてUIがVST_INBOUND_STREAM_ERRORを報告します[8]。
ビルドは問題なく起動してシグナリングサーバーに登録できても、最初のストリーム購読や、約1日の稼働のあとで失敗することがあります。
| 手順 | 確認すること | 失敗したときの様子 |
|---|---|---|
| 起動ログの確認 | 対応づけの検証、audio curve source付きのアクターの登録、フレームレート上限のログ行があり、設定r.GPUStatsEnabled=0が効いていることを確認します。そのうえで、ポート8021[9]が待ち受けていて、クラスター内からのGET /healthに応答することを確認します。 | ログ行が欠けている、または、podがRunningのままなのにポート8021が応答しません。 |
| 長時間稼働試験 | 12時間以上、30分ごとに記録します。対象は、コンテナの再起動、GPUメモリの推移、アイドル中の名前テーブル(FName)の増加です。 | FNameが増え続けるのは、調べるべき異常の兆候です。以前の長時間稼働でのクラッシュを再現して、FNameの増加が原因だと特定するには至っていません。 |
FNameの増加については、レンダラー作者が、毎フレーム生成される名前をUnreal Engine 5.5のリアルタイムGPUプロファイラーまでたどりました。この増加は無操作時に再現し、r.GPUStatsEnabled=0を設定した短時間の試験では止まりました。それが以前のクラッシュの原因だったことは示せていないため、公演日の前には毎回、レンダラーのpodも作り直しています。
5. アバターが何を記憶するかを決める、pipecatの2つの細部
pipecat 0.0.68の2つの振る舞いが、モデルが後で自分の回答として目にする内容を決めます。
1つ目は契約です。TTSサービスがLLMFullResponseEndFrameを転送するのはpush_text_framesが有効なときだけで、無効なときは「サブクラスが行う必要がある」とされています[10]。私たちのTTSクラスは、run_ttsが自前でテキストフレームを送出するので、push_text_framesを無効にしています。そのため終了フレームは捨てられ、assistant context aggregatorは、設計上の確定ポイントを一度も受け取れませんでした。
私たちは2026-09-04に、コントローラーのpod内で、縮小したパイプラインを使ってこれを再現しました。割り込みのない3ターンを、各バリアントにつき1回ずつ実行しています。修正なしでは、3つの回答がすべて未確定のままでした。合成のあとにフレームを1回転送すると、3つとも確定しました。pipecatのコードを読む限り、完全なパイプラインのaggregatorは、botが話し終えたときにも確定を行います。これは文と文の間でも起こるので、修正がないと、確定は各回答の終わりではなく、発話の切れ目に合わせて起こります。稼働中のスタックでは、この点を切り分けて確認していません。
注記:pipecat 0.0.108(pull request #4145)以降は、基底クラスが終了フレームを自分で送出します[11]。それらのバージョンでも、音声のないターンではフレームが失われます。この問題は、2026-09-28の時点でまだ解決していません[12]。0.0.68でこのオーバーライドを使う場合は、ターンが音声を生成したかどうかにかかわらず、フレームが転送されます。
2つ目は、割り込みがどう記録されるかです。割り込みが起きると、pipecatは、テキストフレームがすでにaggregatorに届いている文を確定し、残りを捨てます。これは2026-09-04に、pod内での1回の実行で再現しました。そこで私たちのTTSサービスは、各文のテキストフレームを、その文の音声がすべて流れ出たあとに送出します。これにより、音声の途中で切られた文は、話したものとしては記録されません。精度は1文単位です。このサービスは、word timestampなしで音声を返すからです。次のリクエストの履歴では、途中で切られた回答に「聞き手に遮られた回答」という意味の接頭辞が付きます。
6. 無音が続かないように設計する
ターンの中の5秒の無音が、私たちが越えないと決めた上限、つまり無音の上限(dead-air limit)でした。設計上の判断はすべて、この上限に照らして確認しました(図 2)。
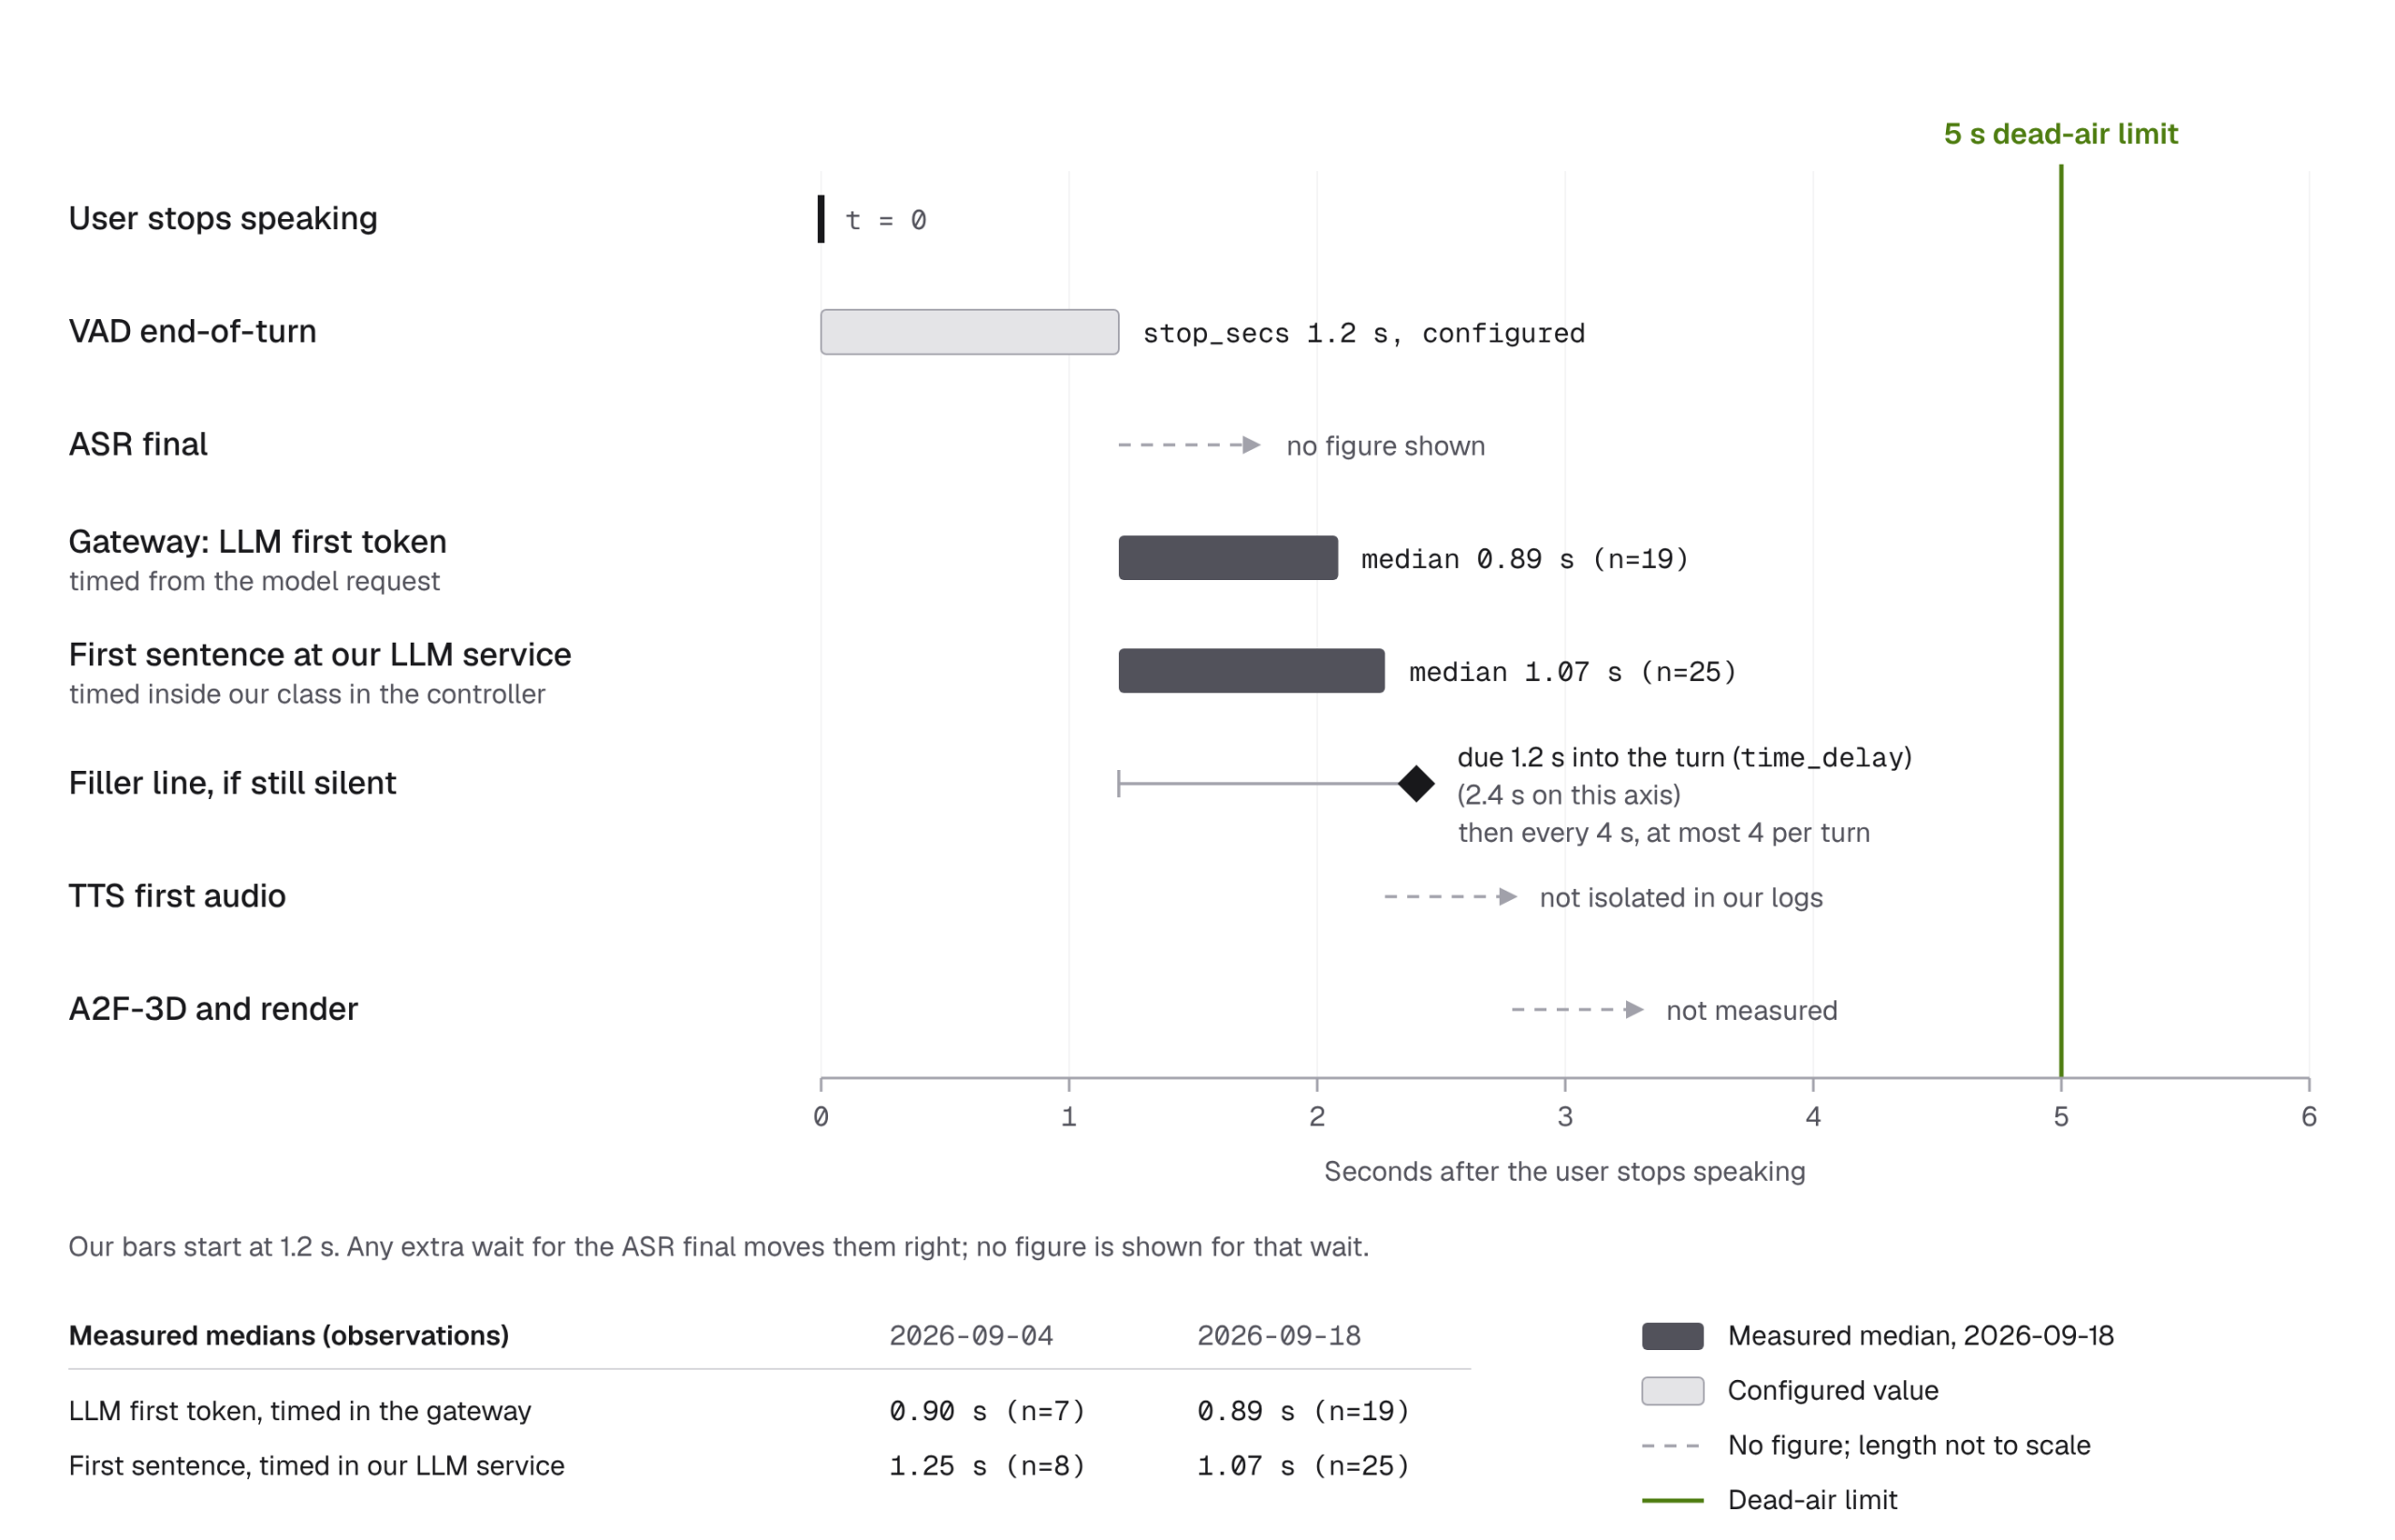
図 2の2つの測定系列は起点が異なるので、足し合わせることはできません。また、最初の文の系列は、最初の文より前に割り込みがあるとそこで計時が止まるので、低めに出ることがあります。マイクからスピーカーまでは、一度も測っていません。
私たちのLLMサービス内にある、フィラー(filler line)用のウォッチドッグは、最後にTTSへ送ったテキストからtime_delay秒後に、最初のフィラーを話します。私たちは1.2 sで運用しました。その後は、無音がさらに4秒続くごとにもう1つ話し、1ターンあたり最大4つまでで、モデルの最初の文が来た時点で止まります。
フィラーはモデルがまだ何も言っていないうちに流れるので、何かを主張してはなりません。テストでは、はいかいいえで答える質問のあとの「ええ、ええ」が、誤った「はい」になりました。私たちは同意を表す6つの文を削除し、聞き手の発話の意図ごとにフィラーの候補を分けました。意図はモデルの呼び出しではなく、文末に対する決定論的な規則で判定します。質問に相づちを返すことはなく、陳述に「いい質問」を返すこともなく、意図が不明なときは中立的な間投詞を使います。分類を誤っても、余分に加わるのは相づちか「いい質問」だけで、回答になることはありません。分類の誤りがどのくらいの頻度で起きるかは、測っていません。filler: []は削除せずに残してください。削除すると、標準の英語のフィラーが戻ってきます。
LLMのフェイルオーバーは、切り替え可能区間(switch window)の中でだけ許されます。この区間は、ターンの開始から、モデル自身の最初の文がgatewayを出るまでです。フィラーでは、この区間は閉じません。区間が閉じたあとは、そのターンの間、プロバイダーは固定されます。server-sent events(SSE)で届くLLMのストリームは、[DONE]かfinish_reasonで終わったときだけ成功とみなします。途中で止まっただけのストリームや空の回答は、失敗です。クラウドのキーを無効にした試験(2026-09-02、n=2ターン)では、ローカルの32Bモデルが、fallback reason authで回答しました。
stop_secs 1.2 s、フィラーのtime_delay 1.2 s、以降は4 sごと、1ターンあたり最大4つ)、それ以外の時間はすべて説明用の値で、測定値ではありません。動画中の文字は英語で、字幕は英語、日本語、中国語から選べます。動画 1のナレーションは、オープンソースの音声合成モデルに付属する既成の音声を使って、AIで生成したものです。アバターの声ではありません。また、システム自体はこのモデルを使っていません。遅いターンでは、どの無音も5 sには達しません。ただし、この場面の主系はすぐに失敗します。もし主系がタイムアウトまで応答しないまま止まっていたら、4つのフィラーをすべて使い切っても、まだ待ちが続いていたはずです。つまり、ウォッチドッグだけでは無音の長さを抑えきれません。割り込みの場面では、音声がTTSサービスから完全に流れ出た文だけが残り、次のリクエストでその回答は聞き手に遮られたものとして記録されます(第5節)。
推論(reasoning)型のモデルは禁止しています。考えている間、contentが空のままだからです。OpenAIのgpt-5.6-terraは、2026-08-17に3回実行して、私たちの採用チェックに合格しました。どの回でも、最初のcontent deltaがすぐに届き、reasoning deltaはなく、正常に終了しました。
2026年9月のライブイベントの2日間で、リハーサルとスタッフによるテストを含め、gatewayのログには405件の会話リクエストが記録されていました。gatewayはそのすべてにHTTP 200で応答しており、警告やエラーの記録はありませんでした。ただし、このログだけでは、すべてのターンが最後まで完了したことも、フェイルオーバーが起きなかったことも証明できません。空の回答は警告を出さずにフェイルオーバーすることがあり、ログにはターンごとの結果が残らないからです。
7. 日本語の音声を正しく聞こえるようにする
Rivaを英語から日本語のストリーミングConformer[13]に切り替えるには、2か所をそろえて編集する必要があります。1つ目はtriton0 Deploymentのモデルの引数で、mainコンテナとmodel-initコンテナの両方でrmir_asr_conformer_unified_ja_jp_str:2.19.0にします。2つ目はbot.pyのASRサービスで、language="ja-JP"と、モデルconformer-unified-ja-JP-asr-streaming-asr-bls-ensembleを指定します。先にtriton0を適用してReadyになるのを待ち、riva-speechを再起動してから、bot.pyを編集してコントローラーのpodを作り直します。事前に古いモデルをコピーして退避しておいてください。デプロイに失敗すると、モデルのディレクトリが空になってしまうからです。
イベント固有の名前と用語36個を、nvidia-pipecatの既定のスコア4.0で、word boostingの対象語として渡しています[14]。その効果は測定していません。周囲の雑音が、「ok」のような短い英単語として確定されることがありました。現在は、ASCII文字だけからなる12文字以下の確定結果と、息づかいのような仮名1文字は、ターンにも履歴の項目にもなりません。その代わり、本当に「NVIDIA」と言った場合も捨てられます。
プロンプトでアラビア数字を禁止しているので、モデルは年を二〇二六年のように書き、クラウドTTSはそれを1桁ずつ読み上げていました。TTSサービスは、年の直前にある3桁または4桁の漢数字を、位取りのある形(二千二十六年)に書き換えます。同じ文の音声は、桁ごとの形で4.29 s、位取りの形で3.44 sでした(各1クリップ、2026-09-04)。
そのほかの語は、読みの表で扱います。表に登録するには、まず人が耳で誤読を確認し、次に仮名に書き換えたものが正しく読まれることを耳で確認する必要があります。どちらも別々の2回のサンプルで確かめます。クラウドTTSは、同じ文でも毎回同じ音声を返すとは限らないからです。2回のサンプルでも足りないことがありました。キャラクター自身の名前の書き換えは、この確認に合格したあと、デプロイ済みのスタックで誤読しました。
8. 肌ではなく映像の経路を直す
ブラウザ上のアバターは、レンダラーのフレームより暗く見え、特に中間調で暗くなっていました。このずれはオフセットではなく、ガンマカーブのように見えました(図 3)。この測定は2026-09-17に、1台のクライアントで、本番に出したバイナリを共有する2つのビルドについて行いました。
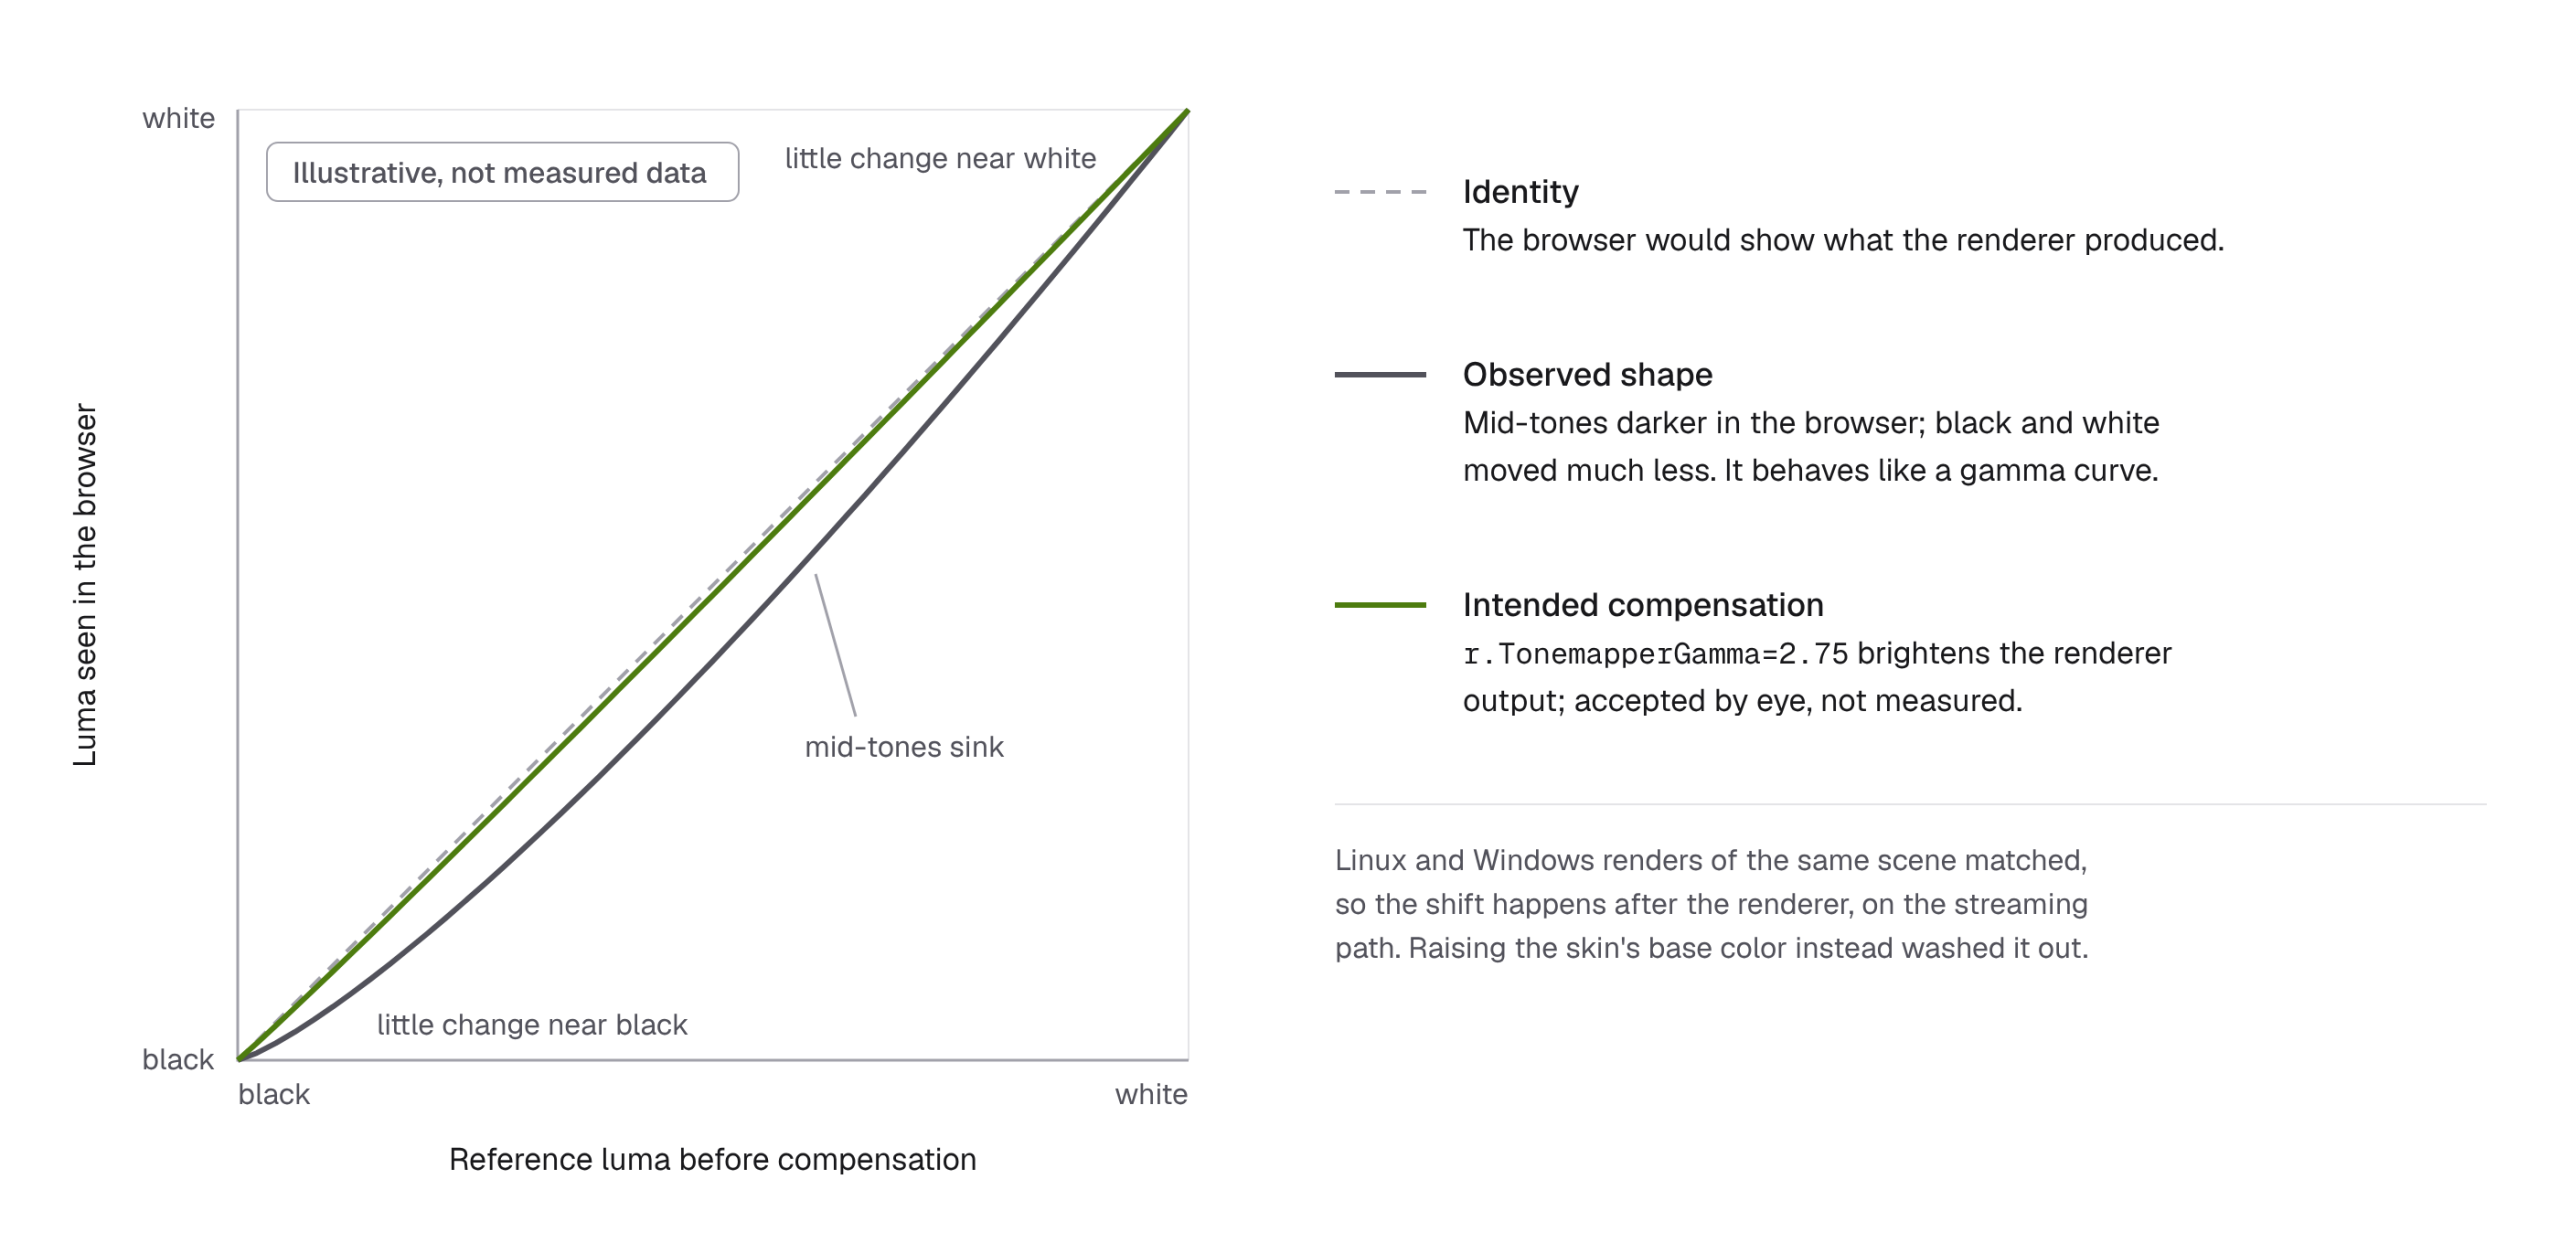
原因はレンダラーではありませんでした。Linuxでの描画は、同じビルドのWindowsでの描画とも、エディターのビューポートとも一致しました。このずれのうち、どれだけがVSTで生じ、どれだけがクライアントで生じたのかは、切り分けていません。肌を明るくするのは、誤った対処でした。顔のベースカラーの倍率を2倍にすると、顔が白っぽく飛んでしまいました。
本番で採用した修正は、起動引数の-ini:Engine:[ConsoleVariables]:r.TonemapperGamma=2.75で、結果は目視で確認して受け入れました。解像度とエンコーダーはレンダラーのStatefulSetの環境変数で、具体的にはIAUEMS_WINDOW_WIDTH、IAUEMS_WINDOW_HEIGHT、そしてガンマのフラグも運ぶIAUEMS_DEPLOYMENT_ADDITIONAL_STARTUP_ARGSです[9]。chartの既定値は1280x720とVP8で、私たちは1920x1080にしました。helm upgradeを行えば、これらの値は再生成されてしまいます。私たちの起動時チェックは、ずれがあればkubectl set envのコマンドを表示します。
9. GPU podが気づかれないままGPUを失うとき
Tokkio 5.0のGPU pod(VST、Audio2Face-3D、Triton、Riva、Animation Graph、レンダラー)は、NVIDIAのランタイムとNVIDIA_VISIBLE_DEVICESを通じてGPUを得ています。この変数は、4つのpodではpod specで設定されています。RivaとAnimation Graphは何も設定しておらず、すべてのGPUが見えています。どのpodもnvidia.com/gpuを要求していません。私たちのノードでは、containerdをcgroup v2上のsystemd cgroupドライバーで動かし、toolkitのlegacy hookを使い、CDIは無効にしていました。この構成では、GPUの利用許可は、NVIDIAのhookがsystemdの知らないところで書き込むデバイスルールの中にしか存在しません[15]。systemctl daemon-reloadが走ると、どのような場合でも、この許可を含まないルールが作り直されます[16]。私たちの環境でのreloadは、毎日のパッケージ更新のタイマーとsnapの更新から来ていました。
注意:reloadの原因になっているタイマーを無効にすること自体が、reloadを起こします。systemctl disableとenableはsystemdのデーモンをreloadするからです。この操作は、Tokkioのワークロードをゼロにスケールしている間だけ行ってください。
reloadの時点では、何も壊れません。カーネルがデバイスの権限を確認するのはopenのときだけなので、開いているハンドルは動き続け、すべてのpodはRunningのままです(図 4)。次のopen()が、誤解を招くエラーとともに失敗します。VSTはブラウザのセッションごとに新しいハードウェアエンコーダーを開くので、reload後の最初のセッションでVSTがクラッシュし、それが繰り返されました。ログは/dev/v4l2-nvencが原因だとしていましたが、x86では、そのライブラリは/dev/nvidia0から/dev/nvidia15までを順に試しています。クラッシュの瞬間に権限のエラーを捉えたことはないので、これは私たちの手元の証拠で最も裏付けのある説明です。
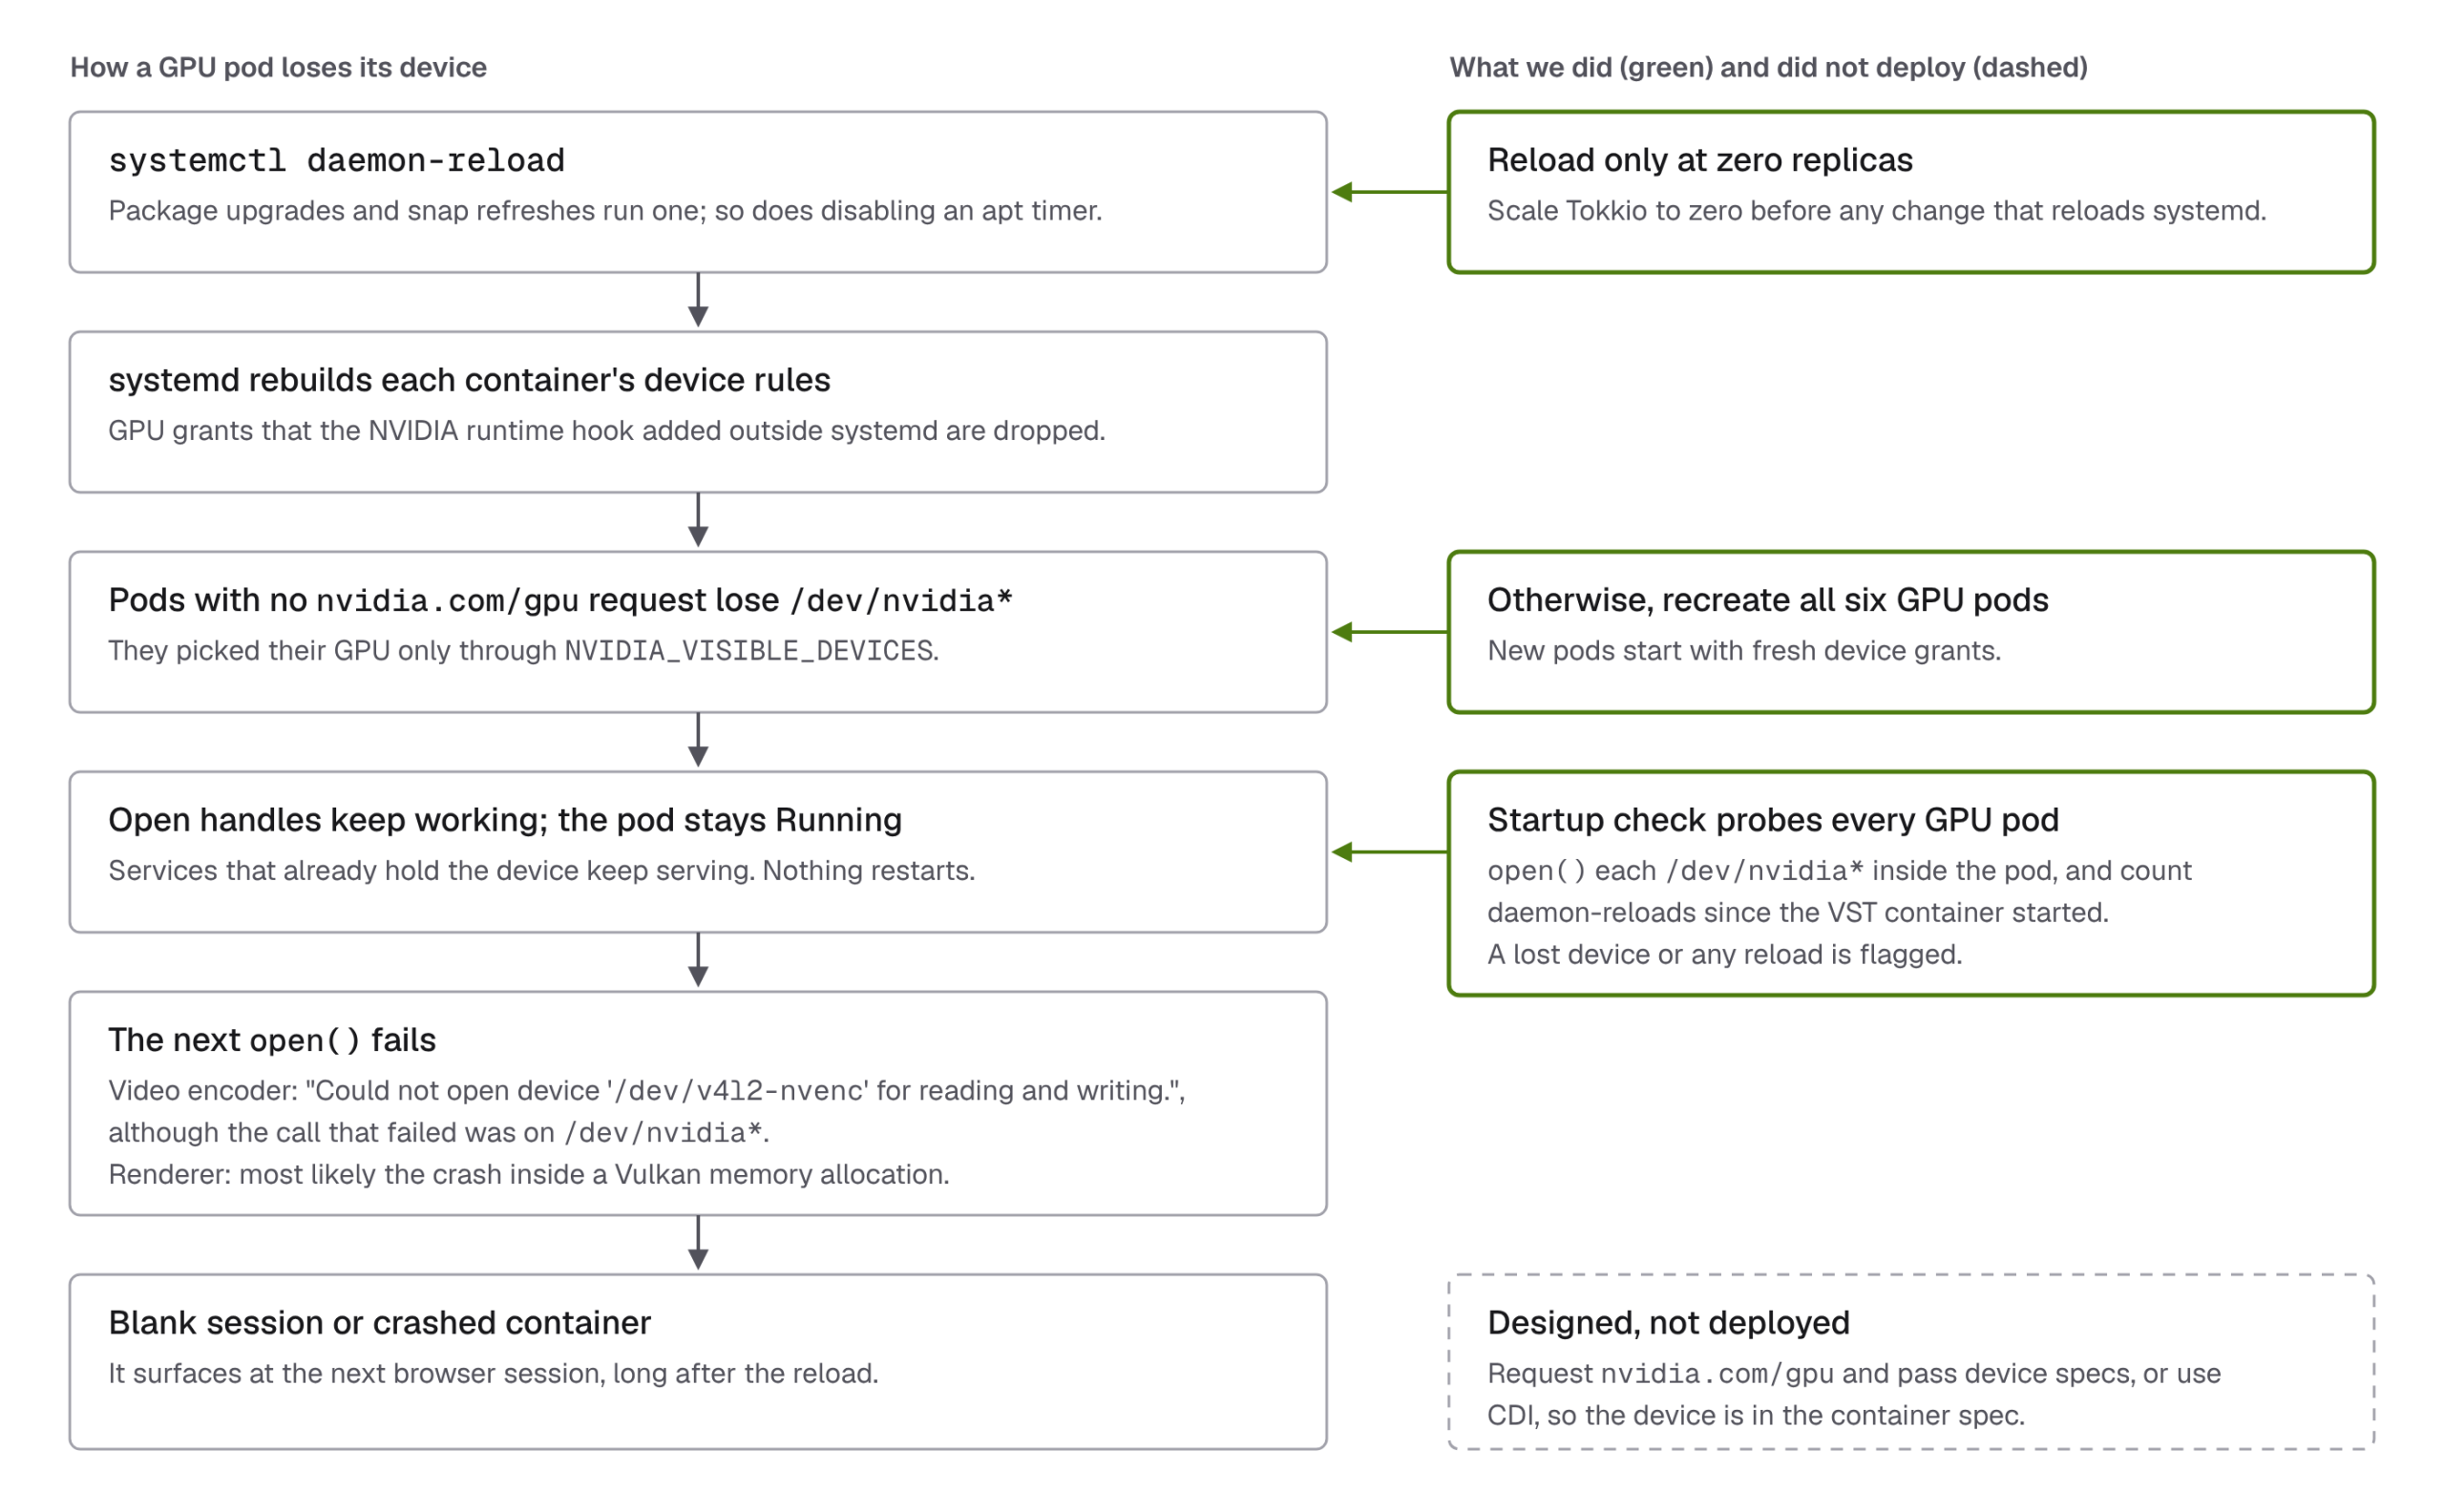
2026-09-18に、私たちはステージを動かしたまま、aptのタイマーを無効にしました。すると、6つのGPU podのうち5つが、アクセスを失いました。私たちのルールは、systemdをreloadする操作はすべて、レプリカがゼロのときに行うというものです。reloadが紛れ込んでしまったら、その発生源を止めてから、すべてのGPU podを削除します。起動時チェックは、各GPU podの中ですべての/dev/nvidia*をopenし、VSTの起動以降のreloadの回数を数えます。構造的な対策として私たちが設計したのは、2つの案です。1つは、デバイスの指定を渡すようにデバイスプラグインを設定したうえでnvidia.com/gpuを要求する案、もう1つはCDIです。どちらも、デバイスがコンテナの仕様に入るようにするものです[15]。公演の前に行うには、どちらもリスクが大きすぎると判断し、どちらも導入しませんでした。
新しいカーネルへ手動で再起動したときには、競合状態が加わりました。toolkitのDaemonSetがcontainerdの設定を書き換える前に、kubeletがTokkioのpodを再起動したので、それらのサンドボックスには/dev/nvidia*がありませんでした。CrashLoopで再起動されるのはコンテナであって、サンドボックスではありません。そのため、toolkitのDaemonSetがReadyになるのを待ってから、podを削除してください。
10. よくある問題とその修正箇所
第1部は、アセットの症状の表で締めくくりました。これは、そのランタイム版です。
| 症状 | 修正箇所 |
|---|---|
| レンダラーと映像 | |
add_streamが400を返す。音声は出るが映像が出ない | stream helperの GetActor() が返すアクターは UACEAudioCurveSourceComponentを持っていません。Unrealのビルドを修正してください。 |
| レンダラーのクラッシュ後、podはRunningなのに、どのセッションでも何も映らない | エンジンがポート8021をbindし直せないことがあります。podを削除し、クラスター内から:8021/healthを確認します。 |
| GPUとクラスター | |
ホストのメンテナンス後、最初のセッションでVSTがクラッシュする。ログは/dev/v4l2-nvencが原因だとしている | daemon-reloadがGPUへのアクセスを取り消しています。reloadはレプリカがゼロのときだけ行い、そうでなければすべてのGPU podを削除します(第9節)。 |
11. 測定していないこと
マイクからスピーカーまでの遅延、ASRの文字誤り率、word boostingで何が変わったか、フィラーの意図の判定規則がどのくらいの頻度で誤分類するかは、一度も測っていません。Tokkioの経路で、再生とAudio2Face-3Dが同じPCMを受け取っていることも、検証していません。本番に出したレンダラーのバイナリそのものには、連続12時間の長時間稼働試験の記録がありません。イベント本番については、遅延レポートのもとになるコントローラーのログが、ステージをゼロにスケールした時点で失われました。
シリーズの到達点
第1部は引き渡しパッケージで締めくくられ[1]、本記事はそのパッケージを、実際に動くステージに載せました。第1部はアセットとその表情の契約を受け持ち、この第2部はその周りのランタイムを受け持ちます。ACEのランタイムとの接続は第3節と第4節で、レンダラーのアクターの毎フレームの経路は第4節で、統合する側の視点から扱いました。Unrealレンダラー内のカメラコンポーネントは、パッケージ化されたビルドに含まれています。ブラウザのカメラと音声のストリームを扱うVSTについては、第8節と第9節で扱いました。準備完了が何を意味するかを書き出し、起動のたびにそれを確認し、証拠を残してください。
参考文献
リンクは2026年9月に確認しました。TokkioとACEのドキュメントへのリンクは、アーカイブサイトを指しています。RivaとContainer Toolkitのリンクは現行のドキュメントを指しており、私たちが動かしたバージョンのものではありません。
[1] DTC Tech Blog. Character Creator 5とUnreal EngineでNVIDIA Tokkio用カスタムアバターを作成する →
本シリーズの第1部。引き渡しパッケージと、同記事の第7節にある、52個のACE入力から54個のCC5ターゲットへの対応づけ。
[2] NVIDIA. Tokkio 5.0 GA release notes →
Tokkio 5.0 GA uses pipecat 0.0.68.
[3] NVIDIA. Audio2Face-3D Microservice: リリースノート →
1.3.16の項目を含みます。
[4] NVIDIA. Unreal Renderer Microservice: カスタムアバター、任意のアセット →
ACEプラグインはUnreal Engine 5.3向けに書かれ、ビルドされています。アバターのアクターに付けるACEAudioCurveSource。
[5] NVIDIA. Tokkio 5.0: Architecture →
The answer path from Audio2Face-3D through the Animation Graph to the renderer.
[6] NVIDIA. ACE Controller Microservice: ユーザーガイド →
pipecatにnvidia-pipecat拡張を加えたものとしてのコントローラー。
[7] NVIDIA. Tokkio 5.0: カスタマイズオプション →
config.yamlのllm_processorと、標準の3つのLLMサービス。bot.pyでの、TTSを含むほかのプロセッサー。
[8] NVIDIA. Tokkio 5.0: Tokkio UIのトラブルシューティング →
VST_INBOUND_STREAM_ERROR:UIがアバターの受信ストリームに接続できないことを示すエラー。最も多い原因はTURNの問題。
[9] NVIDIA. Unreal Renderer Microservice: パラメーター →
HTTP APIのポート8021、既定値がそれぞれ1280と720であるIAUEMS_WINDOW_WIDTHとIAUEMS_WINDOW_HEIGHT、そして追加の起動引数。
[10] pipecat. tts_service.py at v0.0.68 →
With push_text_frames off, the subclass must push LLMFullResponseEndFrame.
[11] pipecat. Pull request #4145: TTSの改善 →
0.0.108以降、音声のあるターンでは、基底クラスが終了フレームを送出します。
[12] pipecat. Issue #5654: push_text_frames=FalseのTTSServiceが、音声を生成しないターンのLLMFullResponseEndFrameを落とす →
2026-09-28の時点で未解決。
[13] NVIDIA. Riva ASR Overview →
Language table including Japanese (ja-JP) Conformer models.
[14] NVIDIA. 音声認識の基礎とRiva ASRのカスタマイズ →
リクエスト時のword boosting。
[15] NVIDIA. NVIDIA Container Toolkit: トラブルシューティング →
systemdが管理するcgroupでは、daemon-reloadによって、legacy hookが与えたGPUへのアクセスが失われます。デバイスノードを明示的に指定するか、CDIを使えば、これを防げます。
[16] NVIDIA. gpu-operator issue #503: NVIDIA_VISIBLE_DEVICESを使うKubernetesのコンテナが、systemctl daemon-reloadのあとにデバイスへのアクセスを失う →
NVIDIA_VISIBLE_DEVICESを使うコンテナは、daemon-reloadでGPUへのアクセスを失います。リソースを要求しているpodは、アクセスを保ちます。
ピンバック:Creating a Custom Avatar for NVIDIA Tokkio with Character Creator 5 and Unreal Engine – DIGITAL TWIN CENTER